
AI 系列-2:揭秘 LLM 大语言模型
ChatGPT
ChatGPT 火爆出圈
ChatGPT 官网:https://openai.com/blog/chatgpt/
2022 年 11 月 30 日:OpenAI 公司通过一篇博客向大众推出了名为 ChatGPT 的 AI 聊天机器人。人们登录 OpenAI 官网,向 ChatGPT 提出问题,就能获得答案。OpenAI 公司这样介绍自己的新产品:” 我们训练了一个名为 ChatGPT 的 AI 模型,你可以通过对话的方式与它交互,它能够回答后续的问题、修正之前回答中的错误、质疑不正确的前提条件以及拒绝不当的请求。” 介绍中所说的 AI 模型指的是采用深度学习技术的人工神经网络,OpenAI 公司称之为 GPT。
ChatGPT 聊天机器人一经推出,立刻成为互联网用户追捧的热门产品,更多 AI 聊天助手雨后春笋一般出现在大家的视野里。
2022 年 12 月 5 日:OpenAI 公司创始人山姆·奥特曼 (Sam Altman)发布了一条推特(Twitter):” 今天,ChatGPT 的用户数量超过了 100 万。”

面对新浪潮,我们关心的不再只是过去那种过于宏大的问题。比如,如果机器会思考,人类的命运将会如何发展?现在,我们所关心的问题还与自身紧密相关:别人在用这些新推出的 AI 工具做什么?我们如何快速掌握和熟练运用这些新技术?一些危言耸听的媒体报道甚至让人们陷入对未来的担忧:我会被 AI 取代吗?
其实,你不会被 AI 取代,但如果不紧跟浪潮,就可能会被熟练运用 AI 的人取代。
OpenAI、GPT 和 ChatGPT 的区别
| OpenAI | 它是一个专门研究人工智能的实验室、研究机构 |
|---|---|
| GPT | 它是 OpenAI 开发一系列基于人工智能的大语言模型(GPT1.X/2.X/3.X/4.X) |
| ChatGPT | 它是 OpenAI 公司基于 GPT-3 这大语言模型开发出来的一款具体的产品 |
除了 ChatGPT 外,像字节豆包、Claude、文心一言、通义千问等聊天助手,也都是基于大语言模型的应用。

但是大语言模型并不是在 2022 年才开始发展,早在 2018 年 OpenAI 就已经发布了 GPT-1.0,所以大语言模型的发展早就如火如荼了。只是因为 ChatGPT 2022 年直接向公众开放,而且能让用户在网页上用对话的方式进行交互,体验很流畅丝滑,大众的目光才被吸引过去。

ChatGPT 的本质和特征
从用户角度,ChatGPT 就是一款人工智能聊天的产品。
从技术角度,ChatGPT = Chat + GPT。
- Chat:强调此工具能够理解自然语言和人的意图,提供像人一样的能力,例如对话、问答
- GPT:它是 OpenAI 于 2018 年推出的第一代模型的缩写,意思是「生成式预训练转换器」(Generative Pre-trained Transformer)。
- 「Generative」表示生成的,意味着这个模型能够生成新的文本内容;
- 「Pretrained」即预训练,指模型在大规模的文本数据上预先进行训练,学习语言的特征和模式;
- 「Transformer」是一种深度学习架构,它在自然语言处理领域具有强大的处理能力,能够很好地捕捉文本中的语义信息和上下文关系。

用一句话概括,ChatGPT 就是基于 Transformer 架构和无监督训练技术的对话生成式模型,由 OpenAI 公司研发出来的一款人工智能产品,它具有自然语言理解、文本生成、对话生成、自动回复等功能。
Tips:ChatGPT 和传统的对话系统不同,它采用了深度学习的技术,可以自动地从大量的语言数据中学习理解语言的规律、特性,从而实现对话的生成。
三步揭秘 ChatGPT:从「文字接龙」到「贴心助手」的进化之路
预训练:让 AI 学会「语言规则」
第一步:海量文本自学
ChatGPT 的训练起点是「自学语言规则」。想象一个婴儿牙牙学语,它通过阅读 3000 亿个「文字碎片」(token)来理解人类语言的规律。这些碎片包括书籍、新闻、社交媒体甚至代码,覆盖了人类文明的几乎所有领域。

技术核心:无监督学习
- 自学原理:模型通过「填空游戏」学习语言逻辑。例如,看到「今天天气不错,因为____」,它会预测出「阳光明媚」或「适合野餐」。
- 数学本质:将每个文字转换为向量(类似指纹),通过计算向量间的相似度来捕捉语义关联。比如「国王」和「女王」的向量差异,与「男人」和「女人」的差异高度相似。

代价与突破
- 烧钱程度:训练 GPT-3 需要数千块 GPU,耗时数月,成本高达数百万美元。
- 能力涌现:随着参数规模突破千亿,模型突然展现出「举一反三」的能力,例如理解代码逻辑、进行数学推理。
监督微调:教会 AI「对话技巧」
第二步:人类老师手把手教学
自学成才的 AI 虽然能流畅生成文本,但可能答非所问。例如,你问「如何煮咖啡」,它可能继续写「咖啡是一种饮品……」。因为此时模型有预测下一个 token 的能力,会根据上文补充文本,但并不擅长对话。
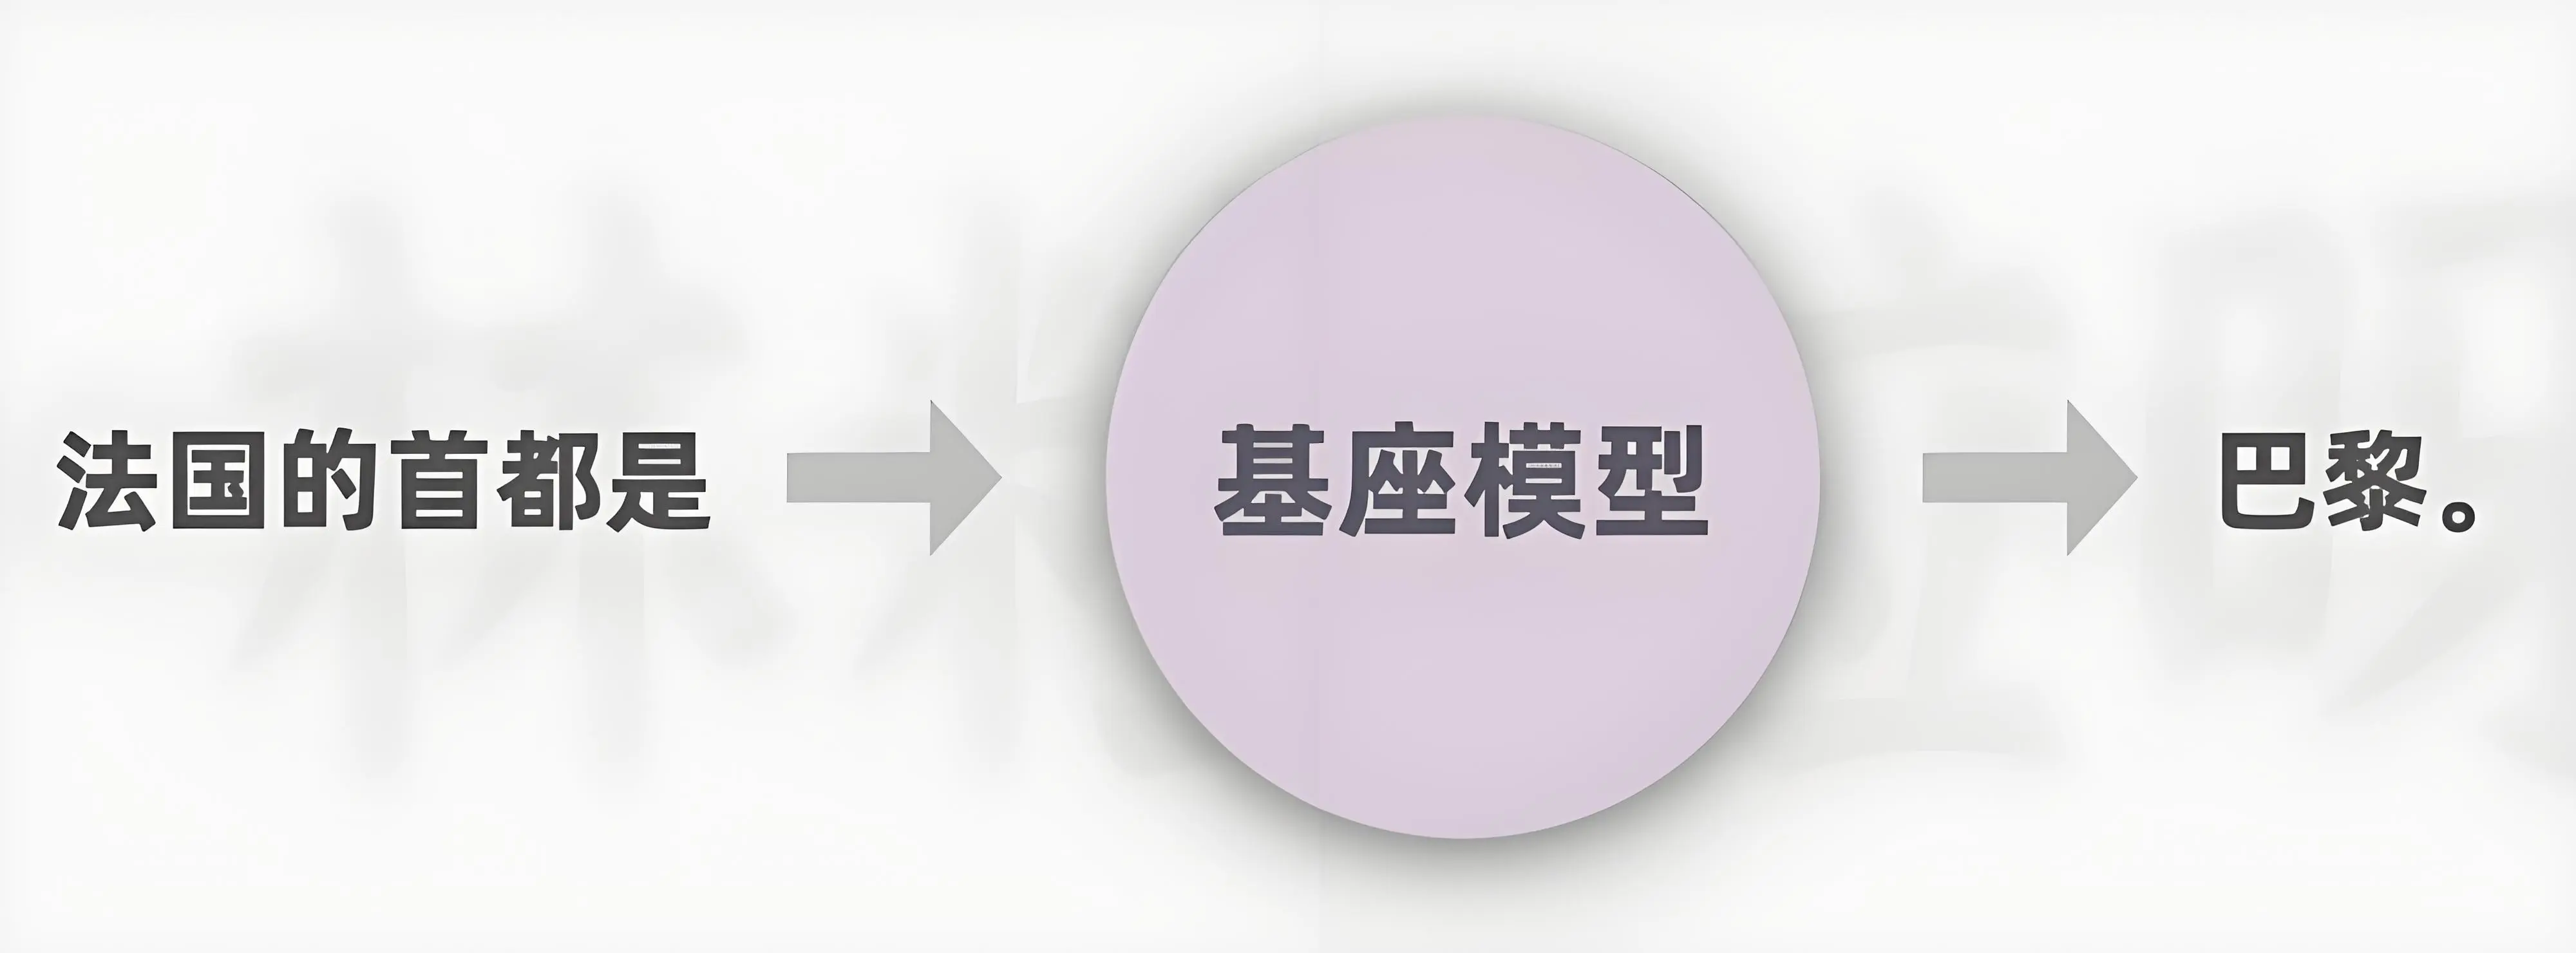
这时需要人类介入,通过「监督微调」(SFT)教会它「有问必答」。在这一阶段里,模型不需要从海量文本学习了,而是从一些人类写的专业且高质量的对话里学习。
具体操作
- 数据准备:收集高质量对话数据,例如「问题 - 专业回答」对。比如:
- 问题:Python 如何读取 CSV 文件?
- 回答:使用 pandas 库的 read_csv 函数……
- 模型调整:用这些数据重新训练模型,让它学会「先理解问题,再生成答案」。
对比实验
- 基座模型:输入「中国首都是哪里?」→ 输出「中国首都是一个重要的城市……」(答非所问)。
- 微调模型:输入同样问题 → 输出「中国首都是北京,位于华北平原……」(直接回答)。

微调 Vs 预训练的成本
| 预训练 | 微调 |
|---|---|
| 大规模数据 | 所需数据更少 |
| 长时间训练 | 训练时长更短 |
| 高成本 | 成本更低 |
强化学习:让 AI「投其所好」
第三步:用「奖励机制」驯化 AI
微调后的模型虽然能回答问题,但可能生成错误信息(如「地球是平的」)或态度生硬。这时需要「强化学习」(RLHF),通过人类反馈让模型学会「投其所好」。

操作流程
生成候选答案:让模型对同一问题生成多个回答(如「如何减肥?」可能得到「少吃多动」「抽脂手术」等)。
人类排序:标注员会根据「有用性、真实性、无害性」,即 3H 原则(Helpful、Honest、Harmless)对回答打分,例如:
- 优质回答:「控制饮食 + 规律运动」(10 分)
- 劣质回答:「只吃水果」(3 分)

训练奖励模型:用人类排序数据训练一个「裁判模型」,让它学会自动给回答打分。
强化学习:模型生成回答后,奖励模型给出分数,模型根据分数调整参数,逐步趋向高奖励的回答模式。


关键技术
- PPO 算法:类似训练小狗,模型每生成一个回答,就像小狗做了一个动作。如果奖励高(如得到零食),模型会强化这种行为;如果奖励低(如被呵斥),则避免这种行为。
- 防止失控:通过「KL 散度」限制模型偏离原始知识,避免生成离谱内容(如推荐危险药物)。

三步进化本质总结
- 第一步: 通过「暴力学习」掌握语言规律,相当于人类的「识字阶段」。
- 第二步: 通过「专业培训」学会特定技能,相当于人类的「学校教育」。
- 第三步: 通过「社会反馈」适应人类需求,相当于人类的「社会毒打」。
初始大语言模型
何为 LLM 模型
大语言模型也叫 LLM(large language model),是用于做自然语言相关任务的深度学习模型。给模型一些文本内容输入,它能返回相应的输出,完成的具体任务可以是生成、分类、总结、改写等等。

LLM 大语言模型也是用于做自然语言相关任务的深度学习模型,它需要大量的文本进行无监督学习。
以 GPT 3 为例,它的训练数据有多个互联网文本语料库,覆盖线上书籍、新闻文章、科学论文、维基百科、社交媒体帖子等等。借助海量的训练文本数据模型,能更多了解单词与上下文之间的关系,从而更好地理解文本的含义,并生成更准确的预测。

大语言模型里的 “ 大 “,重点不是训练用的数据量特别大,而是模型里的参数数量特别多。参数就是模型内部能变的东西,你可以把它想成是模型在训练时学到的知识。
模型碰到输入的数据,怎么做出反应,全靠这些参数,参数也就决定了模型的表现。以前研究语言模型的时候发现,要是用更多数据、更大算力去训练那些参数更多的模型,多数情况下,模型表现会更好。
打个比方,让 AI 学做蛋糕,一种情况只让 AI 调整面粉、糖、蛋的用量,另一种情况,除了面粉、糖、蛋,还能让 AI 调整奶油、苏打粉、可可粉的用量,连烤箱时长和温度也能调。后面这种能调整的变量多,AI 就更有机会做出更好吃的蛋糕,大语言模型也是这个道理,参数多了表现更好。
GPT 模型参数数量发:GPT-1(1.17 亿)-> GPT-2(15 亿)-> GPT-3(1750 亿)
语言模型发展
在 Transformer 架构被提出之前,语言模型的主流架构主要是循环神经网络,简称 RNN。 RNN 按顺序逐次处理,每一步的输出取决于先前的隐藏状态和当前的输入,要等上一个步骤完成后才能进行当前的计算,因此无法并行计算,训练效率低。而且 RNN 不擅长处理长序列,也就是长文本。

由于 RNN 的架构特点,词之间距离越远,前面对后面的影响越弱,所以它难以有效捕获到长距离的语义关系。但在人类自然语言中,依赖信息之间距离较远是很常见的情况。

比如这句话里,正确预测下一个词的关键是距离很远的广东,如果由 RNN 生成后续内容,到了这里的时候,它可能已经把前面的信息忘没了。


为了捕获长距离依赖性,后来也出现了 RNN 的改良版本 LSTM 长短期记忆网络。但是这也并没有解决传统 RNN 无法并行计算的问题,而且在处理非常长的序列时也依然受到限制。

于是后来,Transformer 就诞生了,Transformer 的出现解决了之前模型的很多问题:
自注意力机制: Transformer 能学习输入序列里所有词的相关性和上下文,不受短时记忆影响。
关键在于自注意力机制,它在处理每个词时,会关注序列里所有词,并给予不同注意力权重,这些权重是训练中习得的。这样即便两个词距离远,也能捕获它们的依赖关系,比如能判断 “it” 和 “animal” 关联性比其它词语更强。
位置编码: 语言中顺序很重要。此前的模型按顺序处理输入序列,导致训练只能串行,速度慢。
而 Transformer 在将输入词到神经网络前,除了将词转换为向量,即转换成一串数字,还会把词的位置也用数字表示添加到输入序列的表示中。这样模型既能理解词义,又能掌握词的位置和顺序关系。
借助位置编码,输入无需按顺序,可同时处理所有位置,每个输出能独立计算,大大提高了训练速度,也让训练大模型变得更容易。
自《Attention Is All You Need》发表之后,Transformer 以及它的变体已经被普遍运用在大型数据集上来训练大语言模型,所以 Transformer 架构对我们当下能拥有那么多牛叉的大语言模型功不可没。


大语言模型的能力
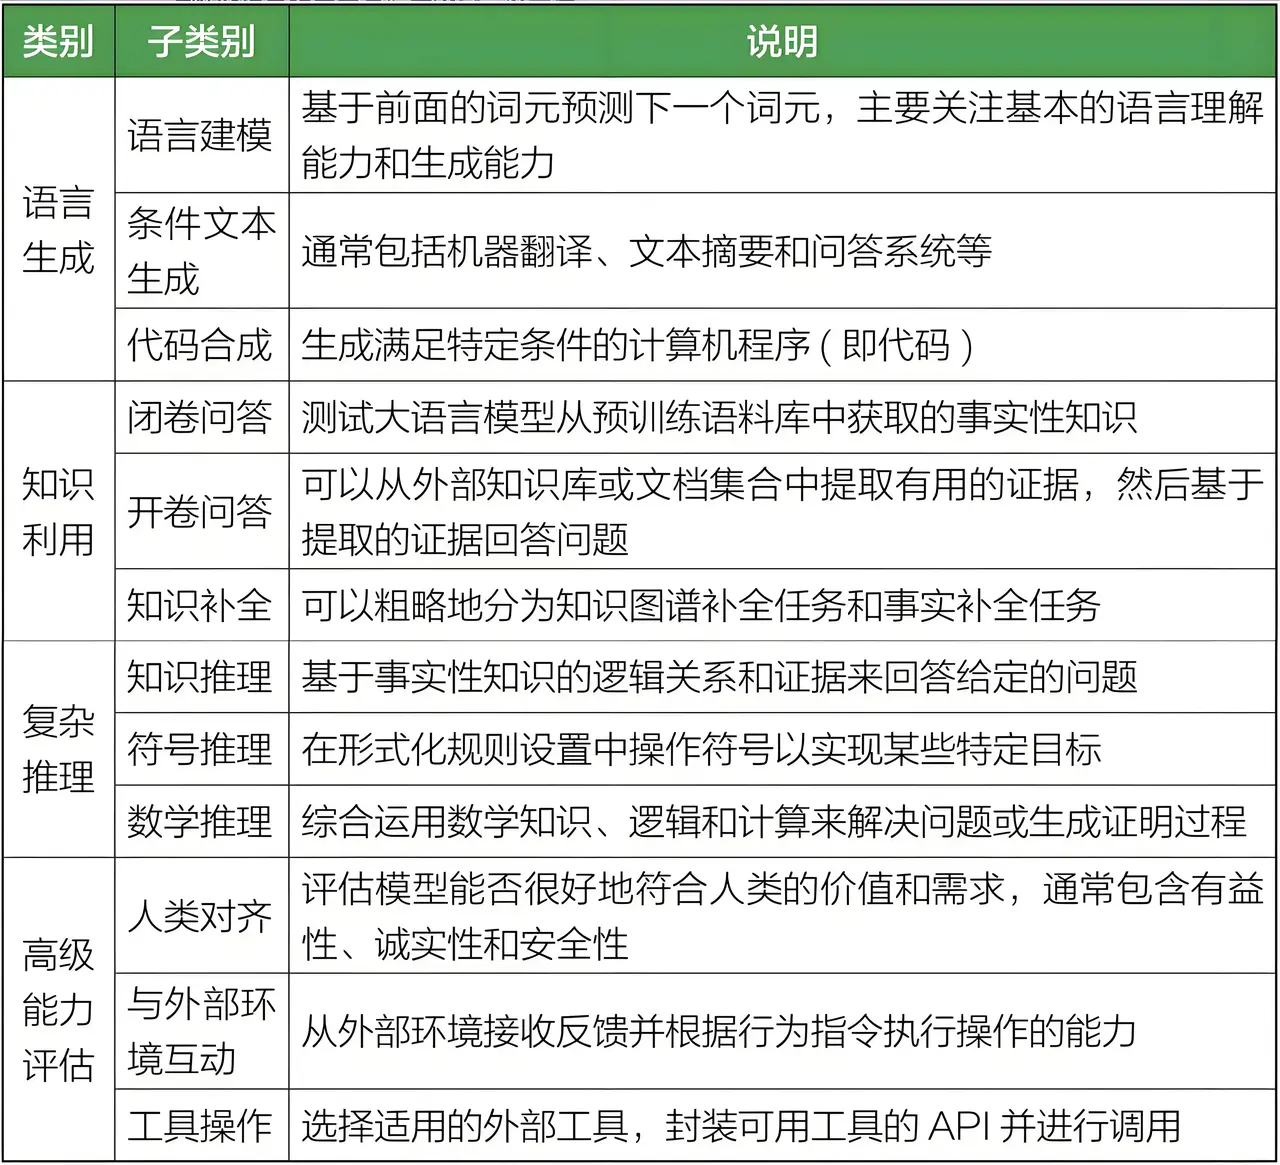
大语言模型的能力大概可以分为四层:聊天能力(智能客服)、语言能力(翻译)、文本能力(写代码)、推理能力(场景较多)。
大语言模型和传统 AI 的区别
| 大语言模型 | 传统 AI | |
|---|---|---|
| 能力 | 大语言模型就像个知识渊博又聪明的学霸,能理解和生成超自然的文本,还能做翻译、写文章、回答问题啥的 | 传统 AI 更像是个偏科生,一般只能在特定小领域干活,像简单的图像识别、语音识别 |
| 学习方式 | 大语言模型是在超级多、超级杂的数据里 “ 疯狂学习 “,用的是深度学习这种复杂的方法 | 传统 AI 更像是照着老师给的规则、模板学习,用的是比较简单的算法 |
| 灵活度 | 大语言模型很灵活,遇到不同任务能很快调整适应 | 传统 AI 要是换个任务,就像重新学一门课,得重新设计算法 |
| 花费 | 大语言模型训练起来费钱又费电,得用超厉害的计算机硬件 | 传统 AI 就比较 “ 省钱 “,对硬件要求没那么高 |
简单来讲:
- 小模型(传统 AI):针对特定应用场景进行训练,能完成特定的任务。
- 大模型:针对无标注数据上进行训练,可以完成多个应用场景的任务,实现通用的智能能力。

Transformer 模型
快速了解
2017 年,为了研究自然语言处理和理解,谷歌提出了新模型 Transformer。在此基础上人们又研发出了 BERT、GPT-3 系统,这两个系统在自然语言的生成和问答方面都取得了令人瞩目的成果。
其最初用于机器翻译,将一种语言转换为另一种语言,即根据源语言的语义和目标语言的词汇概率补全句子的下一个词。后来,这个架构逐渐用于完成更一般性的生成任务,比如续写文章。
GPT 模型是怎么知道后面应该补全什么内容呢?
它实际上是一个「内容词预测器」软件,它所做的是根据前面的词和概率预测下一个词。它一个词、一个词地补全下去,就「写」出了给我们的回答。
GPT 模型又是怎么预测下一个词的呢?
简单地说就是,它「看」了极其多的文本资料。通俗地说就是,研究人员用巨量的文本训练了这个模型。它可以根据前面的词,计算出后面的词出现的概率,然后把概率最高的词作为下一个词。
对此,史蒂芬·沃尔弗拉姆 (Stephen Wolfram)举例说,根据前面一段话,模型预测后面的 5 个单词依次是(按概率排序):learn、predict、make、understand、do。那么,GPT 模型就会把 learn 作为下一个词。之后,它又接着预测下一个词。
实际上,我们可以通过调整「温度」(temperature)指标来调整选择下一个词的概率。所谓的「温度」指的是体现随机性的指标。
- 「温度」越低,随机性越低。模型总是选择概率最高的词,这时你可能会觉得它比较古板。
- 「温度」提高,随机性增高。模型会在一组词中随机选择下一词,从而每次产生的结果会有很大的差异,这时你又会觉得它比较有创意。
GPT 模型如何判断下一个单词出现的概率是多少呢?
多层人工神经网络中的参数或权重 (parameters/weight)决定了下一个词出现的概率,这些参数是通过用超大数量的文本对人工神经网络进行训练而调整到位的。
这也是 GPT 中「P」的含义 —— 对人工神经网络进行预训练 (pre-trained),让它掌握预测下一个词所需要的参数(GPT-3.5 拥有 1750 亿个参数)。
Transformer 核心结构
Transformer 架构由两部分组成:编码器(Encoder)和解码器(Decoder)。
- 首先在编码器部分,输入的文本会被拆分成若干个 token(可以理解是文本的基本单位)。
- 接着将 token 进行向量化之后给到解码器,解码器就会根据预训练的内容生成最终结果。
Tips: Token 数量不等同于单词或文字的数量,对于一个长单词来说,它可能会被拆分成多个 token。这也就是为什么你明明输入的单词或文字数量没有达到 token 限制的数量,却还是提示你超长了。
假如现在我们要用 Transformer 来做英语翻译法语的任务,给编码器输入一句英语,然后让解码器返回对应的法语,接下来我们看看整个过程中会发生什么。

输入预处理
Token 化
作用: 将文本拆分为基本单位(Token,如单词、子词),并转换为整数 ID(Token ID),便于计算机处理。
我们先看编码器部分,输入的文本首先会被 token 化,也就是先把输入拆分成各个 token,token 可以被理解为是文本的一个基本单位,取决于不同的 token 化方法。短单词可能每个词是一个 token,长单词可能被拆成多个 token。
然后每个 token 会被用一个整数数字表示,这个数字被叫做 token ID。这样做是因为计算机内部是无法储存文字的,任何字符最终都得用数字来表示。

有了数字表示的输入文本后,就会再把它传入嵌入层。
嵌入层(Embedding Layer)
作用: 将 Token ID 转换为词向量(Vector)(一串数字),包含语法、语义信息。
嵌入层的作用是让每个 token 都用向量表示,向量可以被简单地看为一串数字,为了能在画面里放下,这里把向量长度简化为 3,但实际中向量长度可以非常长。
而这里之所以要将单个数字再拆分成一串数字,其中一个原因是一串数字能表达的含义是大于一个数字的,能包含更多语法、语义信息等等。

这就好比男人和女人这两个词他们都在描述人类,但性别又是完全相反的。如果只用一个数字表示,这两个数字大小之间应该距离很大,还是应该距离很小呢?

但如果有多个数字,我们就可以进行更多维度的表示。就比如说第一个数字可以表示「是雌性」的程度,第二个表示「年龄大」的程度,第三个表示「社会阶层高」的程度。
所以嵌入层的向量不是随便搞出来的,里面包含了词汇之间语法、语义等关系,相似的词所对应的嵌入向量,在向量空间里距离也更进,而一些没啥关系的词之间的距离就更远。这有助于模型利用数学计算向量空间里的距离,去捕捉不同词在语义和语法等方面的相似性。

而且,男人与国王的差异和女人与女王的差异可以被看作是相似的,这也可以在多维向量空间里展现。因此,词向量不仅可以帮模型理解词的语义,也可以捕捉词与词之间的复杂关系。
这里为了直观是用三维向量空间表示的,把向量长度相应简化成了 3。但提出 Transformer 的论文里,向量长度是 512,GPT-3 是 12288,所以可以想象它能包含多少信息。
通过编码器的嵌入层得到词向量后,下一步是对向量进行位置编码。
位置编码(Positional Encoding)
作用: 将词的顺序信息转换为向量,与词向量相加,让模型理解文本顺序。
Transformer 中一项关键机制就是位置编码,而位置编码就是把表示各个词在文本里顺序的向量和上一步得到的词向量相加,然后把得到的结果传给编码器。

这样做的意义是模型,既可以理解每个词的意义,又能够捕捉词在句子中的位置,从而理解不同词之间的顺序关系。
编码器(Encoder)工作流程
核心目标
重点: 将输入文本转换为包含词汇、顺序、语法语义的「抽象向量」表示。
接下来就到了编码器这个核心部分,它的主要任务是把输入转换成一种更抽象的表示形式。这个表示形式也是向量,即一串数字里面既保留了输入文本的词汇信息和顺序关系,也捕捉了语法语义上的关键特征。

关键机制
自注意力机制(Self-Attention)
作用:
 - 处理每个词时,关注输入序列中所有词(而非仅邻近词),通过计算相关性分配注意力权重。

 - 输出融合当前词与上下文信息,同一词在不同上下文有不同表示。
捕捉关键特征的核心是编码器的自注意力机制,模型在处理每个词的时候,不仅会关注这个词本身和它附近的词,还会关注输入序列中所有其他词。
自注意力机制通过计算每对词之间的相关性来决定注意力权重。如果两个词之间的相关性更强,它们之间的注意力权重就会更高。
比如这个例子,单从语法上来讲,it 可以指 animal,也可以指 street。而自注意力机制发现了 it 与 animal 更强的关联,所以给 animal 的权重会更大一些。
但由于自注意力机制对上下文的全面关注,那在输出的表示结果里不仅包含这个词本身的信息,还融合了上下文中的相关信息。
上下文在语言里很重要,也能揭露相同词的不同含义,所以在解码器输出的结果里,表示各个词的向量会根据上下文信息进行调整,同一个词根据上下文有不同的抽象表示。
多头自注意力(Multi-Head Attention)
作用: 多个独立注意力头并行工作,关注文本不同特征(如动词、修饰词、命名实体等),提升模型对复杂关系的捕捉能力。
自注意力机制涉及到很多计算步骤,更多细节可以在论文原文里关注一下。Transformer 实际上使用了多头自注意力,也就是编码器不只有一个自注意力模块,而是有多个。
每个头都有它自己的注意力权重,用来关注文本里不同特征或方面。比如有的关注动词,有的关注修饰词,有的关注情感,有的关注命名实体等等。而且它们之间可以做并行运算,也就是计算进展上互不影响。
每个字注意力投的权重,都是模型在之前的训练过程中,从大量文本里逐渐学习和调整的。
前馈神经网络(Feed-Forward Network)
作用: 对自注意力输出进一步处理,增强表达能力。
在多头自注意力后面还有一个前馈神经网络,它会对自注意力模块的输出进行进一步的处理,增强模型的表达能力。


堆叠增强
作用: 多个编码器堆叠(结构相同,权重不共享),逐层深入提取特征。
而编码器在 Transformer 里也不止有一个,实际上是有多个堆叠到一起,每个编码器内部结构一样,但不共享权重。这样模型能更深入地理解数据,处理更复杂的文本语言内容。

解码器(Decoder)工作流程
核心目标
重点: 基于编码器的抽象表示,生成目标序列(如翻译后的法语)。
看完编码器,接下来看解码器的部分,它是大语言模型生成一个个词的关键。
通过前面的编码器,我们有了输入序列里各个 token 的抽象表示,接着可以把它传给解码器。而解码器还会先接收一个特殊值,这个值表示输出序列的开头。

这样做的原因是,解码器不仅会把来自「编码器的输入序列的抽象表示」作为输入,还会把之前「已经生成的文本」也作为输入,来保持输出的连贯性和上下文相关性。
关键机制
带掩码的自注意力(Masked Self-Attention)
作用: 生成文本时,仅允许关注已生成的前文词,禁止 “ 偷看 “ 后文,确保按顺序预测。具体的生成过程仍然是要经过多个步骤,首先和编码器一样,文本要经过我们已经了解过的嵌入层和位置编码,然后被输入进多头自注意力层,但它和编码器里的自注意力层有点不一样。
当编码器在处理各个词的时候,它会关注输入序列里所有其他词。但解码器中自注意力只会关注这个词和它前面的其他词,后面的词要被遮住不去关注。
这样做是为了确保解码器生成文本时遵循正确的时间顺序,不能给它偷看到后面,在预测下一个词时,只使用前面的词作为上下文,这种类型的多头自注意力被叫做带掩码的多头自注意力。
跨注意力(Cross-Attention)
作用: 连接编码器输出和解码器输入,融合原始输入信息与生成序列的上下文。带掩码的多头自注意力是针对已生成的输出序列的,而在后面,解码器还有个多头自注意力层,这里就是前面「编码器输出的输入序列的抽象表示」所派上用场的地方。
注意力会捕捉「编码器的输出」和「解码器即将生成的输出」之间的对应关系,从而将原始输入序列的信息融合到输出序列的生成过程中。
解码器里的前馈神经网络作用和编码器里的类似,也是通过额外的计算来增强模型的表达能力。而且和编码器一样,解码器同样是多个堆叠到一起的。
这可以增加模型的性能,有助于处理复杂的输入输出关系。


输出处理
作用: 通过 “ 线性层 + Softmax” 把向量转为概率分布,选概率最高的词作为下一个输出。
解码器的最后阶段包含一个线性层和一个 Softmax 层,它们俩加一块的作用是把「解码器输出的表示」转换为词汇表的概率分布。

这个词汇表的概率分布代表下一个被生成 token 的概率,那么有些 token 的概率就会比其他的高。在大多数情况下,模型会选择概率最高的 token 作为下一个输出。

现在我们知道了解码器本质上是在猜下一个最可能的输出。至于输出是否符合客观事实,模型无从得知,所以我们能经常看到模型一本正经地胡说八道,这种现象也被叫做幻觉。

解码器的一整个流程会重复多次,新的 token 会持续生成,直到生成的是一个用来表示输出序列结束的特殊 token。

Transformer 变种
但以上描述的架构是《Attention Is All You Need》论文里的原始 Transformer 架构,即编码器用来理解和表示输入序列,解码器用来生成输出序列。实际上,在原始架构的基础上,后续出现了一些变种,主要有三个类别:仅编码器、仅解码器以及编码器 - 解码器。

仅编码器(Encoder-only)/ 自编码模型 —— 适合 “ 理解型 “ 任务
一句话总结:“ 我看懂了,现在做判断!”(适合理解、分析)
- 结构: 只保留原始 Transformer 中的编码器部分(没有解码器)。
- 编码器的作用是 “ 理解输入 “,比如把一句话转换成包含语义和顺序的 “ 数字密码 “(向量)。
- 怎么用: 将输入一段文本,编码器层层处理后输出 “ 密码 “,然后基于这个 “ 密码 “ 完成任务(比如判断情感、填空)。
- 核心特点:
- 可以 “ 看到全文 “(自注意力不遮挡后面的词),适合分析整个句子的关系。
- 不生成内容,只做 “ 理解 “ 和 “ 判断 “。
- 场景: 阅读理解、情感分析、关键词提取(比如判断 “ 这篇评论是好评还是差评 “)。
- 例如,BERT(比如你让它 “ 猜 “ 句子里被遮住的词,如 “ 猫坐在____ 上 “,它能根据上下文填 “ 地毯 “)、RoBERTa 等模型。

仅解码器(Decoder-only)/ 自回归模型 —— 适合 “ 生成型 “ 任务
一句话总结:“ 我开始编了,想到哪写到哪!”(适合生成、创作)
- 结构: 只保留原始 Transformer 中的解码器部分(没有编码器)。
- 解码器的核心是 “ 一个词一个词地猜下一个词 “,比如从 “ 今天天气 “ 猜到 “ 很好 “。
- 怎么用:
- 输入一个起始信号(比如 “ 开始生成 “),然后每次根据前面生成的词,预测下一个词,直到结束。
- 过程中只能 “ 看前面的词 “(后面的词被 “ 遮住 “,避免 “ 偷看答案 “),符合人类说话的顺序(先说前半句,再说后半句)。
- 核心特点:
- 专注 “ 生成 “,擅长 “ 顺着思路往下编 “,比如写文章、对话、写诗。
- 不需要提前输入完整内容,边想边输出。
- 场景: 写作文、聊天机器人、代码生成(比如根据前半行代码补全后半行)。
- 例如,GPT 系列(比如 GPT-4,你让它写一个故事,它会一句一句 “ 编 “ 出来)、PaLM 等模型。

编码器 - 解码器(Encoder-Decoder)—— 适合 “ 输入输出转换 “ 任务
一句话总结:“ 你给我输入,我帮你转换成你要的输出!”(适合转换、翻译)
- 结构: 同时保留编码器和解码器,编码器先 “ 理解输入 “,解码器再 “ 生成输出 “。
- 比如翻译:编码器把英语句子变成 “ 密码 “,解码器把 “ 密码 “ 翻译成法语句子。
- 怎么用:
- 编码器处理输入(如英语句子),得到 “ 密码 “;解码器用这个 “ 密码 “ 作为参考,结合自己生成的历史内容,逐步输出目标内容(如法语)。
- 解码器生成时,既能 “ 回顾输入的整体信息 “(编码器的密码),又能 “ 看自己已经生成的部分 “(比如翻译到一半,知道前面翻了什么)。
- 核心特点:
- 适合 “ 跨领域转换 “,比如从一种语言到另一种,或从文本到结构化数据。
- 输入和输出可以是不同形式(比如输入问题,输出答案;输入图片描述,输出图片)。
- 场景: 机器翻译、问答系统(比如输入 “ 怎么煮奶茶 “,输出步骤)、文本摘要(把长文章缩短)。
- 例如,原始 Transformer(论文里用来做机器翻译)、T5(可以同时处理翻译、问答等多种任务)、BART(用于文本摘要、纠错)等模型。

如何成为提问工程师?
GPT 的能力
随着训练所用的文本资料和参数数量的增加,GPT 模型预测下一个词的核心能力越来越强。它似乎也有了语言能力、掌握了知识、学会了推理,这颇有点像人类的成长,当孩子逐渐学会了说话之后,他学习了知识,后来又能够进行推理了。GPT 模型的演进方式是:当加大训练的文本数量后,它的知识与能力会得到大幅度提升。
因此现在我们使用的这些大语言模型:
- 首先,都是经过了大量的学习(即预训练),掌握了基本的知识与能力
- 其次,它们可能会针对专业领域的内容进行再训练(比如,OpenAI 就曾经用代码训练模型,使其具有编程能力)
- 最后,会根据相关指令对它们进行微调训练,以使其能够更好地完成与这些指令相关的任务
所以知识性问题是生成式 AI 最擅长的,你可以用它来做很多事情:
- 写通用的代码、寻找 BUG、优化算法 ……
- 改写代码、写 SQL 语句、生成文本 ……
AI 聊天助手的局限性
虽然大模型通过海量的文本训练,学会了模仿人类语言,积累了不少知识。但这种 “ 学习方式 “ 也带来了一些问题:
- 盲目自信的 “ 瞎猜王 “: 遇到不熟悉的领域,AI 并不知道自己 “ 知识匮乏 “,依然会自信满满地 “ 瞎猜 “,就像一个不懂装懂的人,硬着头皮也要说上几句。
- 缺乏反思的 “ 冲动派 “: 在生成回答的过程中,AI 没有反思能力,不会停下来思考自己的回答是否正确,一旦开始 “ 说 “,就一路 “ 狂飙 “,所以经常出现胡说八道还 “ 理直气壮 “ 的情况。
- “ 一视同仁 “ 的生成逻辑: AI 生成每个 token(可以理解为文字、词语等基本单位)的时间差不多,不会因为问题复杂就多花时间思考,这也是它在处理数学计算等需要深度思考的问题时容易出错的原因。

怎么让它的能力为我们所用呢?
提示语是调用 GPT 知识与能力的接口。
针对这种现象,越来越多人开始研究怎么调教出一个聪明的 AI 聊天助手 「提示词工程」,就是研究如何提高和 AI 的沟通质量及效率的核心关注提示的开发和优化。
我们将向 GPT 模型输入的请求就称为提示语,它是使用 GPT 模型所拥有的知识与能力的接口。我们可以通过在搜索引擎上搜索关键词来获取和使用海量的信息(如谷歌和百度所做的)和服务(如亚马逊、淘宝、美团所做的)。现在,我们可以通过提示语来使用 AI 模型所掌握的知识与能力。

实际上,我们可以通过提示语将通用的大语言模型转化为聊天机器人,谷歌 Deepmind 和人工智能公司 Athropic 在论文中都提到了这个技巧,Athropic 的提示语示例展示了如何用长达 6000 个标记符的提示语让模型具有聊天功能。
如何高效的提问?
怎么样才算是好的问题?
- 尽量别问搜索引擎就能很容易解决的问题
- 例如如何安装某个常见的库
- 尽量提供充足的问题背景信息
- 例如不要单纯抛个异常报错截图,一定要将详细的上下文信息提供出来
- 明确你的提问目的是什么?
- 例如不能单纯问怎么学习自动化这个宽泛的问题,提问要具体点
- 比如可以问如何使用自动化落地解决某个具体的问题,也可以问如何利用自动化提升某个模块的效率)
如何提问才能更好的得到想要的答案?
- 采用封闭式提问,将问题控制到有效的范围内
- 例如不要问我毕业后去哪个城市发展好这种问题,别人就算有空回答你,也不知道从何讲起
- 比如可以问我想从事互联网行业,目前我拿到了哪些公司的 offer,待遇是这些,我本身不变的诉求是什么,毕业后是去北京还是上海发展比较好(给明确别人回答的方向)
- 带着过程去提问
- 我这里遇到了一个问题:【问题描述】
- 我经过了以下尝试:【思路细节】
- 但还是不能解决,报错信息如下:【完整报错的信息、截图】
结构化提示语:ICDO
具体来讲,提示语可拆解为以下四个部分:指令、上下文、输入数据、输出要求。”ICDO” 是结构化提示语四个组成部分的英文首字母:指令 (instruction)、上下文 (context)、输入数据 (input data)、输出要求 (outputindicator)。

它由埃尔维斯·萨拉维亚 (Elvis Saravia) 等人总结而来,原本是为用编程接口访问 GPT 的程序员准备的,但现在它也适用于所有想要高效使用 AI 的人。这里列举并解读一个简单的示例。
- 指令 (instruction): 你想让 GPT 执行的特定任务。
“ 你的任务是将中文翻译成英文。” - 上下文 (context): 额外的上下文或背景信息,以引导 GPT 更好地做出响应。
“ 请按此词汇表将这些专有名词进行翻译。” - 输入数据 (input data): 用户实际输入的内容。
“ 需要翻译的句子是:天空是蓝色的。” - 输出要求 (output indicator): 指定输出的类型、格式等。
“ 译文是:The sky is blue.”
当然上面这些要求不是绝对的,可以适当省略,但是大体是按照这个顺序对 GPT 进行提问,这其实也和我们请一个人帮忙完成任务时的交互方式一样:首先说明任务,给出背景信息,然后提供任务的具体信息,最后提出对于结果的明确要求。
GPT 也像人一样,越靠后的信息它记得越清楚。如果你先给出具体任务,再说明背景信息,它可能会混淆具体任务与背景信息。我们提问的目的是要得到结果,因此对于结果的要求应放在最后。
同时,有一个被一再验证有效的向 GPT 提问的技巧是,在提示语的开头描述指令(你的任务是将中文翻译成英文),最后再以某种方式重复指令(翻译是:);这会让 GPT 更容易清晰地理解和执行我们的要求。
AI 调教小技巧
小样本提示:给 AI 打个样
当我们直接向 AI 提问时,这属于「零样本提示」,就像是给 AI 出了一道没有任何提示的题目,它的回答往往很难符合我们的预期。这时候小样本提示就可以出场了:
- 什么是小样本提示: 在向 AI 提出问题之前,先给它几个相关的对话示例。这些示例就像是「参考答案」,AI 会利用自身的上下文学习能力,记住这些内容,并模仿着示例的风格和逻辑进行回应。
- 小样本提示的好处:
- 省心省力:因为 AI 会模仿示例的风格,所以我们不用反复强调各种要求,它自己就能从示例中「领悟」我们想要的回答风格和内容重点。
- 引导方向:就像给 AI 指了一条路,让它知道该往哪里「走」,避免回答偏离我们的需求。
- 小样本提示的局限:虽然小样本提示很有用,但也不是 “ 万能药 “。比如在处理数学计算这类 AI 本身就不擅长的问题时,即使给了正确的示例,它还是可能 “ 掉链子 “。因为 AI 生成 token 的特性,让它很难静下心来认真计算,所以计算结果常常出错。错。

思维连:让 AI 一步步来
当小样本提示在某些复杂任务上 “ 失灵 “ 时,思维链就派上用场了!这一概念最早由谷歌在 2022 年的一篇论文中提出,它能显著提升大语言模型的复杂推理能力。
- 思维链的原理:在给 AI 的小样本提示中,不仅展示正确的结果,还详细呈现中间的推理步骤。这样一来,AI 在生成回答时,也会模仿着一步一步地进行推理,把复杂的任务分解成一个个小步骤。
- 思维链的好处:
- 降低错误率:就像我们做题时,把解题步骤写出来,更容易发现错误一样,AI 分步骤推理,也能减少出错的概率。
- 集中注意力:在每一个步骤中,AI 只需要专注于当前的思考,减少了上下文信息的干扰,能更清晰地梳理逻辑,得出准确的结果。
- 超简单的懒人用法:如果你觉得准备小样本提示和推理步骤太麻烦,还有一个 “ 懒人福音 “ 方法!只需要在问题后面加上一句 “let’s think step by step”(让我们来分步骤思考),AI 就会自动生成中间推理步骤,虽然效果可能比精心设计的思维链稍弱,但胜在方便快捷,也能有效提升回答的正确率。率。
