
Golang-03:条件循环 & 集合类型详解

1. 条件与循环
1.1 If Else
go 语言中的 if else 写法和 C / C++ 的类似,其中不同的地方如下:
- if 后面没有括号,如果你写了括号,则在保存代码时编译器会自动帮你去掉。
- if 后面必须大括号,不能像 C / C++ 一样与 if 里面的语句在同一行。
1 | package main |
运行结果:
1 | 7 is odd |
1.2 For 循环
在 go 语言中并没有什么 while、do while 循环,只有 for 循环。最简单的 for 循环就是在后面什么都不加,代表一个死循环。不过循环的过程中可以使用 break 退出,或者 continue 来跳过本次循环后续的代码。另外,for 中间的三段任何一段都可以省略。
1 | package main |
运行结果:
1 | first part |
1.3 Range
在 go 语言中可以通过 range 来快速实现遍历操作,在其遍历时,会返回两个值,第一个是索引,第二个是对应位置的值。如果我们不需要索引的话,可以使用下划线来忽略。
1 | package main |
1.4 Switch
go 语言中的 switch 也和 C++ / C 中的比较类似,不同的地方如下:
- go 语言 switch 后面直接跟的是变量名,而不是加括号。
- 在 C++ 中 switch case 如果不加 break 的话会继续往下跑完所有的 case,而在 go 中则不用加 break,就会自动跳出
- go 语言 switch 可以使用任意的变量类型,甚至可以用来取代 if else 语句。可以在 switch 后面不加任何的变量,然后再 case 里面写条件分支,这样会比一连串的 if else 语句逻辑看起来更加清晰。
1 | package main |
运行结果:
1 | two |
2. 集合类型
2.1 数组
定义:
1 | //一维数组 |
初始化:
1 | /* 一维数组 */ |
遍历:
1 | /* 一维数组 */ |
注意:
[2]string和[3]string是不同的类型[count]string是数组,[]string是切片
2.2 Slice
2.2.1 定义与初始化
定义:
1 | var courses []string |
初始化:
1 | //方法1 - 从数组直接创建 (也可以通过切片创建新的切片) |
注意:
切片数组是左闭右开区间
2.2.2 常用操作
增加元素:
1 | var courses []string |
删除元素:
1 | courseSlice := []string{"go", "grpc", "mysql", "es", "gin"} |
拷贝:
1 | //浅拷贝 - 切片2改动会影响到切片1 |
2.2.3 底层存储原理
1 | //切片的实际存储类型 |

下面我们分场景举两个例子:
- 整形
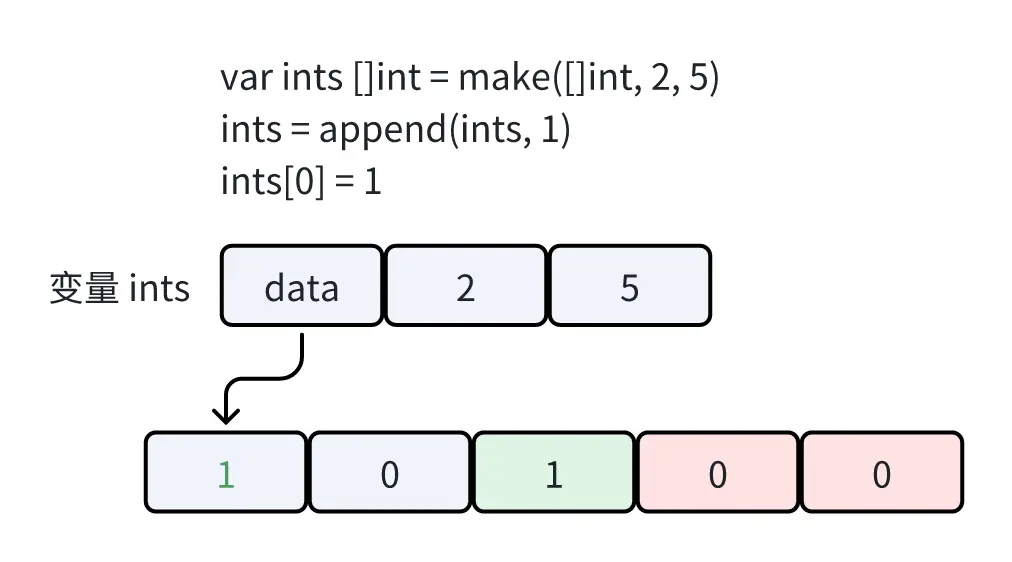
如果我们用 make 来初始化的话,则会分配实际的内存,并且会将元素全部初始化为 0,例如下面我们创建了 5 个大小的空间,但访问的只有前 2 个。

假设我们现在新增一个元素,并更改其中一个元素的值,可以发现容量没变但实际长度变成了 3,但需要注意的是后面两个元素仍不能访问,否则汇报数组越界的错误。
- 字符串
这次我们用 new 来初始化,与 make 不同,new 虽然会创建上面的三部分结构,但并不会分配底层数组空间,所以 data 为 nil。因此,如果我们试图更改数组的值比如 (*ps)[0] = "golang",则会报错。

但是,我们可以通过 append 的方式来分配底层数组

2.2.4 分配位置
可以发现,我们上面举的例子中 slice 的 data 指针都指向 array 数组的第一个元素,但实际上 slice 可以指向 array 数组的任何一个位置。
注意:
array 数组一旦申明了容量大小就不可改变,因此我们可以通过 slice 来灵活的获得我们想要的数组变量。
来举个例子:
下面需要注意的是,s1 的容量计算范围是从开头到底层数组的结尾,因此其容量为 9。

注意:
切片是值传递,但是有引用传递的效果,是因为底层都指向同个地方。一旦增加导致扩容,会指向另一块区域。
我们这里拿 s2 切片数组进行模拟,一旦切片数组发生扩容,则会重新分配一块新的内存,此后对该切片数组的操作都不会再影响到原来的底层数组。

2.2.5 扩容规则
go1.18 之前:

1 | // src/runtime/slice.go |
go1.18 之后:

1 | // src/runtime/slice.go |
举个例子:
1 | func main() { |
按照扩容规则来讲,上面这个例子 2 * 2 < 2 + 3,所以扩容后的容量理应是 5,但是最终的容量却为 6,与规则对不上。
这是因为扩容完之后的容量内存大小可能并不是最终的大小,新分配的内存大小并不是等于预估容量乘以数据类型的大小,而是需要按照一定的内存规格进行匹配。
在许多编程语言中,很多语言中申请分配内存并不是直接与操作系统交涉,而是和语言自身实现的内存管理模块。它会提前向操作系统申请一批内存,分成常用的规格管理起来。我们申请内存时,它会帮我们匹配到足够大且最接近的规格。

所以按上面这个例子来讲,最终分配的内存为 48 个字节,而在 64 位系统中 int 占 8 个字节,故最终的容量不是 40 / 8 = 5 个字节,而是 48 / 8 = 6 个字节。
2.3 Map
2.3.1 定义与初始化
定义:
1 | type class struct { |
初始化:
1 | //方法1 |
注意:
如果只声明没有初始化,放值后打印会报错。
map 必须初始化才能使用,但是 slice 可以不初始化使用。
2.3.2 常用操作
遍历:
1 | //方法1 |
注意:
map 是无序的,而且不保证每次打印都是相同的顺序。这种设计是有意为之的,因为能防止程序依赖特定遍历顺序,而这是无法保证的。
判断是否存在:
1 | //方法1 |
删除元素:
1 | delete(courseMap, "grpc") |
注意:
如果删除不存在的元素,不会报错。
另外,map 不是线程安全的,需要用 sync.Map。
2.3.3 哈希表
说到键值对的存储,我们自然会想到哈希表,至于怎么将键值对存储到哈希桶中,主要有以下几个步骤:
- 通过哈希函数 Hash() 把 “ 键 k1” 处理一下,得到一个哈希值 hash
- 现在需要通过哈希值 hash 从所有桶中选择一个,桶编号范围为 [0, m-1]
- 选择方法有两种比较常用:
- 取模法: hash % m
- 与运算: hash & (m-1)

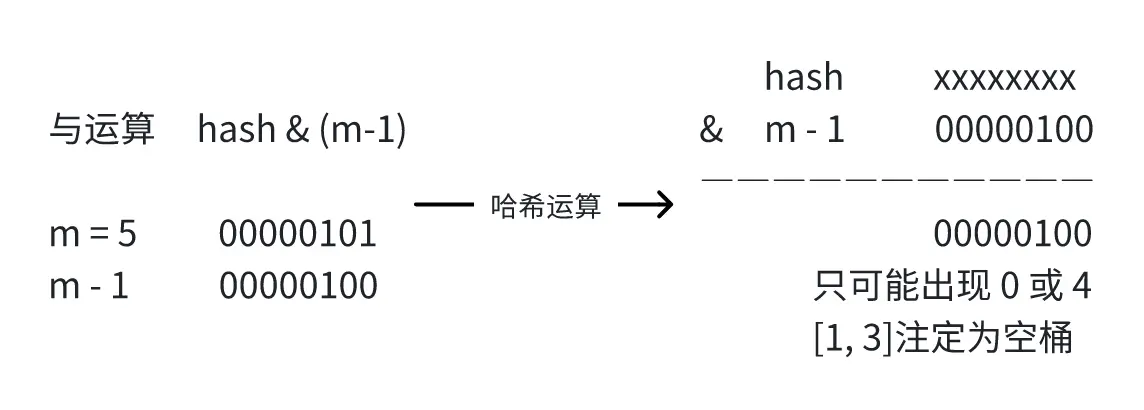
需要注意的是,与运算方法如果想确保运算结果落在区间 [0, m-1] 而不会出现空桶,就要限制桶的个数 m 必须是 2 的整数次幂。这样 m 的二进制表示一定只有一位为 1,并且 m-1 的二进制表示一定是低于这一位的所有位均为 1。

注意:
如果桶的数目不是 2 的整数次幂,就有可能出现有些桶绝对不会被选中的情况。
2.3.4 哈希冲突
知道如何选桶后还要考虑一个问题,如果出现选择的桶冲突了怎么办,下面我们同样来介绍两种常用的方法;
开放地址法
如果 {k2, v2} 选择的桶和 {k1, v1} 选择的一样即发生了冲突,则沿着 {k1, v1} 的桶往后找到第一个没有被占用的桶进行占用。
当要查找 {k2, v2} 时,会从 {k1, v1} 的桶开始比较,如果发现 key 值不相等,则会沿着该桶往后进行比较,直到找到 key = k2 的桶为止。

拉链法
还有一种方法不用沿着桶进行寻找,而是直接在冲突的桶后面链一个新桶存储这个键值对即可。
当要查找 {k2, v2} 时,同样会从 {k1, v1} 的桶开始比较,如果发现 key 值不相等,这次会沿着该桶后面的链表进行比较,直到找到 key = k2 的桶为止。


2.3.5 哈希扩容
上面的哈希冲突会影响到我们哈希表的读写效率,因此选择散列均匀的哈希函数可以减少哈希冲突的发生,另外适时的对哈希表进行扩容也是保障读写效率的有效手段。
通常我们会把存储键值对的数目与桶的数目的比值作为是否需要扩容的判断依据,这个比值被称为 “ 负载因子 “。

当我们需要扩容时,就要分配更多的桶,它们就是 “ 新桶 “,需要把 “ 旧桶 “ 里存储的键值对都迁移到新桶里。
如果哈希表存户的键值对较多,一次性迁移所有桶花费的时间就比较显著。所以通常会在哈希表扩容时,先分配足够多的新桶,然后用一个字段记录 “ 旧桶 “ 的位置 oldbuckets,再增加一个字段记录 “ 旧桶 “ 的迁移进度,例如记录下一个要迁移的 “ 旧桶 “ 编号 nevacuate。
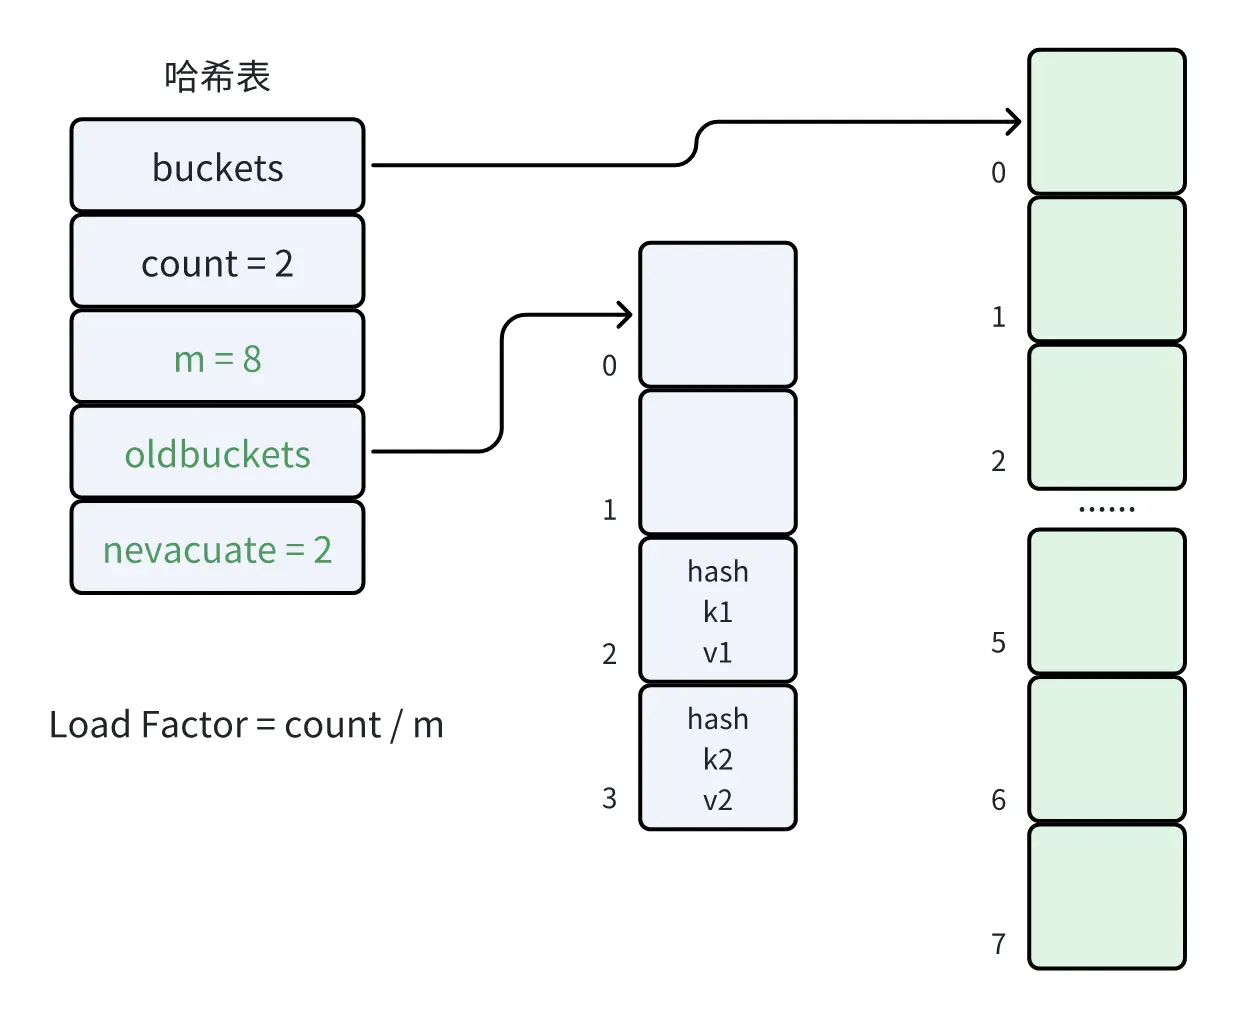
在哈希表每次读写操作时,如果检测到当前处于扩容阶段,就完成一部分键值对的迁移任务,直到所有的 “ 旧桶 “ 迁移完成,” 旧桶 “ 不再使用才算真正完成了一次哈希表的扩容。


像这样把键值对迁移的时间分摊到多次哈希表操作中的方式,就是 “ 渐进式扩容 “ 了,可以避免一次性扩容带来的性能瞬时抖动。
注意:
Go map 的扩容就采用的这种方式,原有的 key 并不会一次性搬迁完毕,每次最多只会搬迁 2 个 bucket。

2.3.6 底层存储原理
在 Go 语言中,map 类型的底层实现就是哈希表,map 类型的变量 a := map[string]string{} 本质上是一个指针 *hmap,指向 hmap 结构体。
1 | type hmap struct { |
map 的桶是用 bmap 结构进行存储,一个桶里可以放 8 个键值对,但是为了让内存排列更加紧凑,所以让 8 个 key 放一起,8 个 value 放一起。
在 8 个 key 的前面则是 8 个 tophash,每个 tophash 都是对应哈希值的高 8 位。
1 | // A bucket for a Go map. |
上面 bmap 结构是静态结构,在编译过程中 runtime.bmap 会拓展成以下结构体:
1 | type bmap struct{ |
放在最后的是一个 bmap 型指针,指向一个溢出桶,溢出桶的内存布局与常规桶相同,是为了减少扩容次数而引入的。当一个桶存满了,还有可用的溢出桶时,就会在桶后面链一个溢出桶,继续往溢出桶里面存。
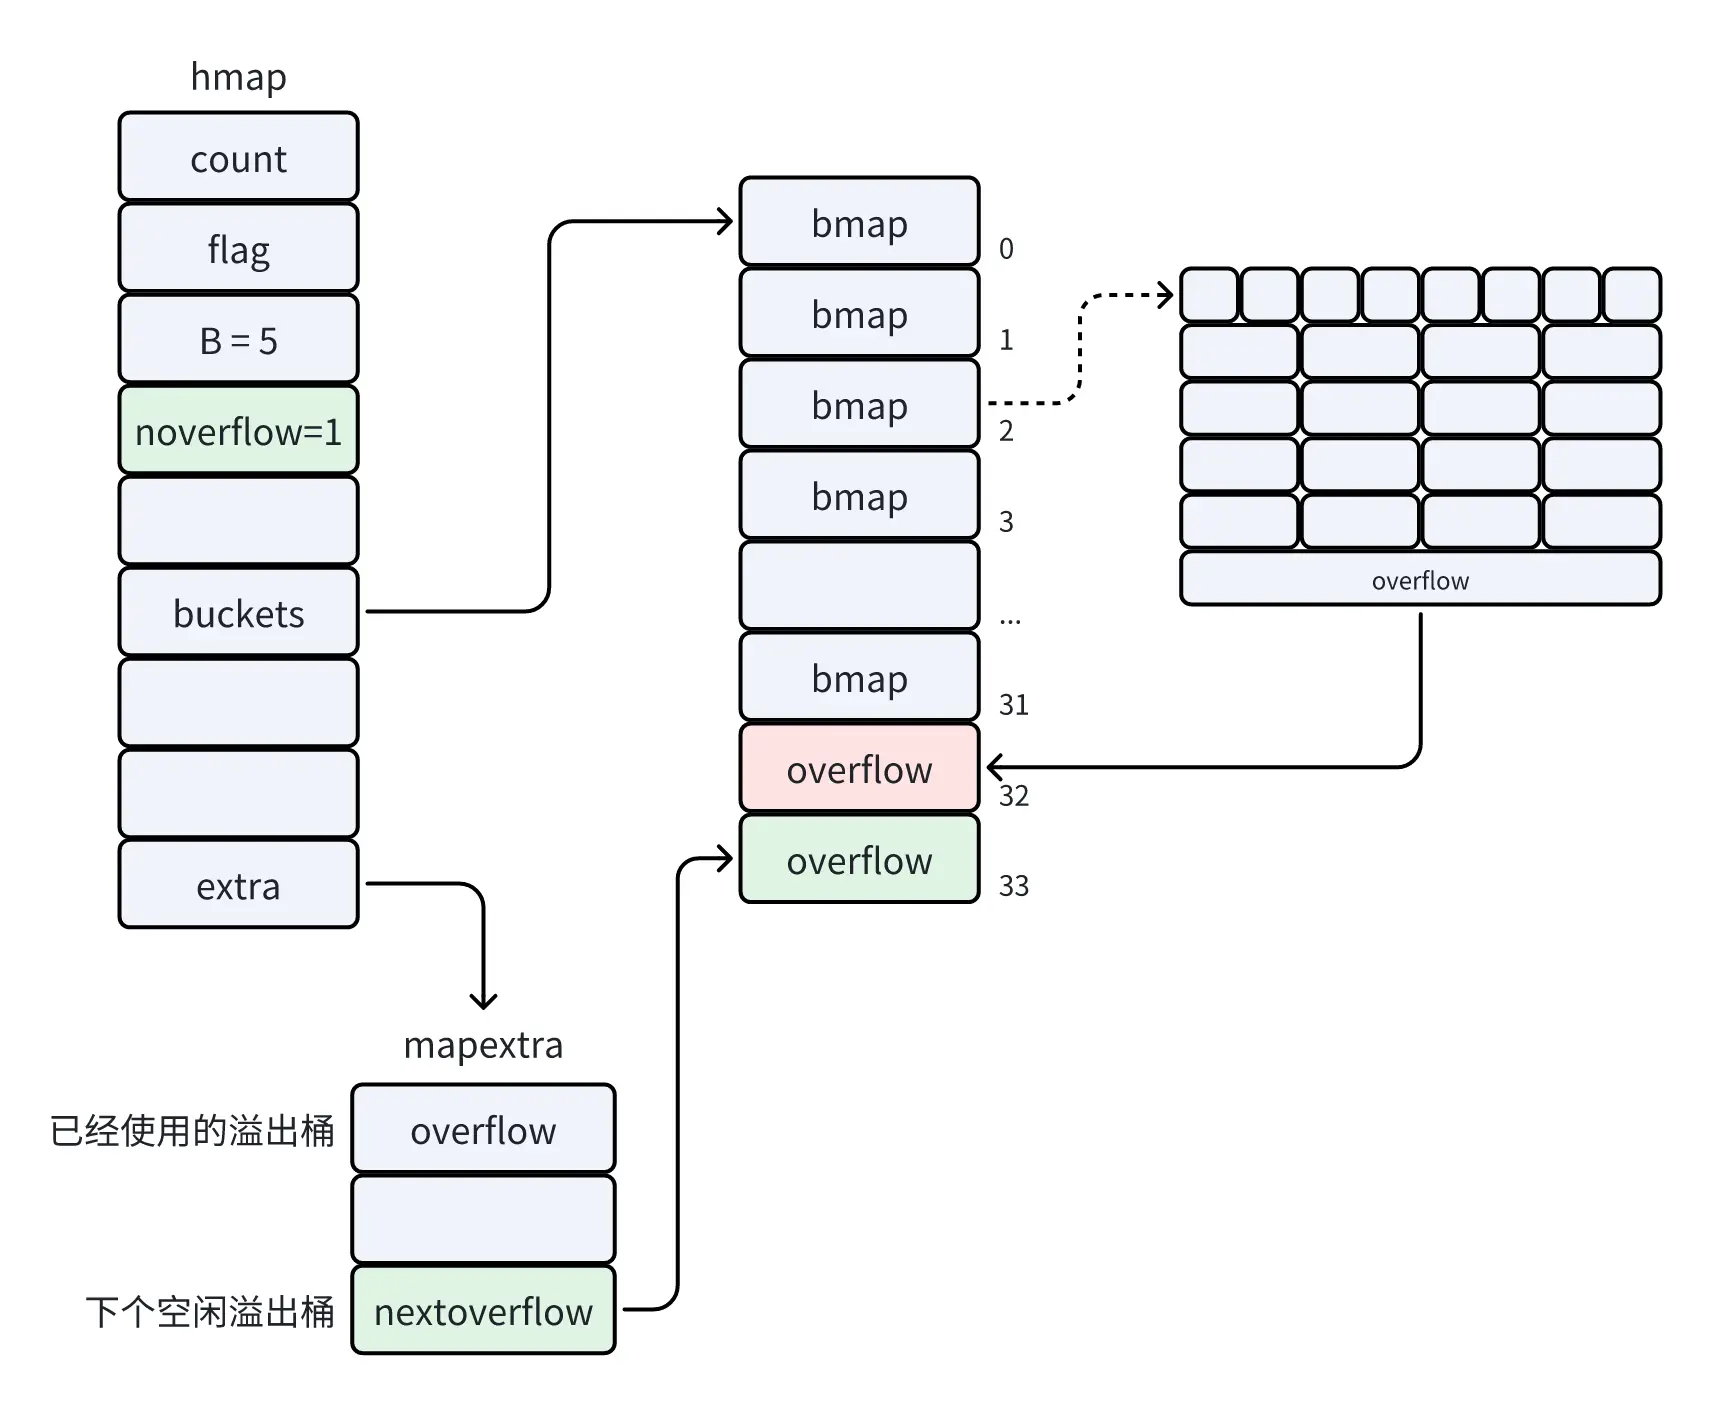
但实际上如果哈希表要分配的桶的数目大于 2^4,就认为使用到溢出桶的几率较大,就会预分配 2^(B-4) 个溢出桶备用,这些溢出桶与常规桶在内存中是连续的,只是前 2^B 个用作常规桶,后面的用作溢出桶。
举个例子,假设 B = 5,那么一共有 2^5 个桶,又因为 2^5 > 2^4,所以就会预分配 2^(5-4) = 2^1 个溢出桶。
也就是说,当 B = 5 时,前 2^5 个会被作为常规桶,而剩下的 2^1 个桶会当做溢出桶使用。

另外,hmap 结构体最后有一个 extra 字段,它会指向一个 mapextra 结构体,里面记录的都是溢出桶相关的信息。其中 nextoverflow 指向下一个空闲溢出桶,overflow 是一个 slice,记录目前已经被使用的溢出桶的地址,而 oldoverflow 则是用于。
1 | type mapextra struct { |

假如现在 2 号桶存满了,它就会在后面链一个溢出桶,而 nextoverflow 就会指向下一个空闲溢出桶,并且此时 noverflow 会记录使用溢出桶的数量即记录此时用了 1 个溢出桶。
我们来看一个例子,变量 a 本质上是一个 hmap 的指针,目前存储了一个键值对,只拥有一个桶,也没有预分配的溢出桶。
下面我们把这个桶展开来看一下,首先是 8 个 tophash,每个占一字节,因为 key 和 value 都是 string 类型,所以 64 位下每个 key 和 value 都占用 16 字节。

目前只存储了一个键值对,取 k1 哈希值的高 8 位 h1 存到 tophash 第一位,而 k1 和 v1 则按照字符串的存储规则进行存储。

如果我们把这个桶存满,接下来继续存储新的键值对时,这个哈希表是会创建溢出桶还是会发生扩容呢?这就要看 map 的扩容规则了。

2.3.7 扩容规则

- 翻倍扩容
当负载因子大于 6.5,即 map 元素个数 / 桶个数 > 6.5 时,就会触发翻倍扩容。
来看源码,其中:
- bucketCnt = 8,一个桶可以装的最大元素个数
- loadFactor = 6.5,负载因子,平均每个桶的元素个数
- bucketShift(B):桶的个数
1 | func overLoadFactor(count int, B uint8) bool { |
回到刚刚那个例子,当存储新的键值对时,我们就需要进行扩容。由于负载因子大于 6.5 了,所以会触发翻倍扩容,旧桶数量为 1,所以新桶数量为 1 * 2 = 2 个。
此时,buckets 就会指向刚分配出来的新桶,而 oldbuckets 则会指向旧桶,并且 nevacuate 为 0,标识接下来要迁移编号为 0 的旧桶,每个旧桶的键值对都会分流到新桶中。

例如,旧桶的数量为 4,那么翻倍扩容后新桶的数量就为 8。

如果一个哈希值选择 0 号旧桶,那么按照旧桶 m = 4 的情况来看,哈希值的二进制低两位一定为 0。

现在新桶 m = 8,那么 0 号旧桶可以迁移的新桶只有两种,取决于哈希值的第三位是 0 还是 1,如果为 0 则迁移到编号为 0 的新桶,反之为 1 则迁移到编号为 4 的新桶。
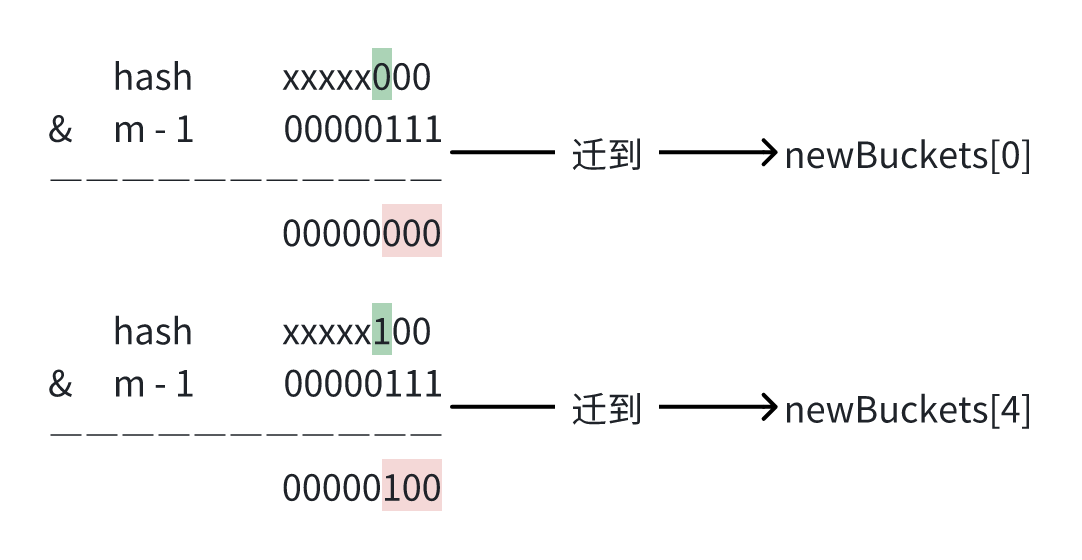
因为桶的数量一定是 2 的整数次幂,所以无论容量为多少,翻倍扩容后,每个旧桶都会按照这样的规律分流道两个新桶中。

- 等量扩容
如果负载因子没有超标,但是使用的溢出桶较多,也会触发扩容:
- 当常规桶数量不大于 2^15 时(B <= 15),此时如果溢出桶总数 >= 常规桶总数(noverflow >= 2^B),则认为溢出桶过多,就会触发等量扩容。
- 当常规桶数量大于 2^15 时(B > 15),此时直接与 2^15 比较,当溢出桶总数 >= 2^15 时(noverflow >= 2^15),即认为溢出桶太多了,也会触发等量扩容。
1 | func tooManyOverflowBuckets(noverflow uint16, B uint8) bool { |
所谓等量扩容,就是创建和旧桶数量一样多的新桶,然后把原来的键值对迁移到新桶中。但是既然是等量,那迁移这些还有什么意义呢?
那当然是有个特殊情况需要我们关注,当有很多键值对被删除的时候,就有可能出现已经使用了很多溢出桶,但是负载因子仍没有超过上限值的情况。
就像下面这个例子,编号为 0 的桶中有很多键值对已经被删除了,此时如果触发了等量扩容,则会分配等量的新桶。而旧桶的每一个桶则会迁移到对应的新桶中,迁移完后可以使每个键值对排列的更加紧凑,从而减少溢出桶的使用。

2.4 List
使用:
1 | package main |