
Golang-10:协程的执行过程

1. 快速了解
goroutine 内存占用小(2k)、切换快,go 语言诞生之后就只有协程可用。
1.1 使用方法
1 | func asyncPrint() { |
1.2 匿名函数启动 Goroutine
1 | func main() { |
1.3 启动多个 Goroutine
下面这里启动 100 个协程打印 i,打印结果可能会出现重复,因为不能保证 goroutine 会什么时候执行。
1 | func main() { |
- 记录临时变量
可以通过临时变量 tmp 来记录 i 的值,从而保证打印的结果不会出现重复的值。
1 | func main() { |
- 值传递
1 | func main() { |
注意:
协程的执行顺序并不一定是顺序的,即上面 100 个 goruntine 打印出来的值不能保证是顺序的。
1.4 GMP 调度原理
go 语言中,每个 goruntine 会被处理器进行管理,一个处理器可以管理多个 goruntine。但每个处理器只能 “ 绑定 “ 一个线程,即处理器管理的 goruntine 中,同一时刻只能选择一个 goruntine 在线程上运行。
并且线程并不会频繁的创建或删除,而是有一个线程池提前初始化好线程,供处理器去调用。这样做就可以省去线程间切换带来的开销,每个 goruntine 就在一个线程上执行即可,不用来回切换线程。
当然,上面只是简单讲解了一下 GMP 的工作机制,其中还会涉及很多复杂的内容,下图只是展示个简化的框架。

2. Hello Goroutine 的执行过程
一个 Helloworld 程序,编译后成为一个可执行文件,执行时可执行文件被加载到内存。对于进程虚拟地址空间中的代码段,我们感兴趣的是程序执行入口,它并不是我们熟悉的 main.main。

不同平台下,程序执行入口不同,在进行一系列检查与初始化等准备工作后,会以 runtime.main 为执行入口创建 main goroutine,main goroutine 执行起来以后才会调用我们编写的 main.main。

再来看数据段,这里有几个重要的全局变量不得不提,我们知道 go 语言中协程对应的数据结构是 runtime.g,工作线程对应的数据结构是 runtime.m。
而全局变量 G0 就是主协程对应的 g,与其他协程有所不同,它的协程栈实际上是在主线程栈上分配的。
全局变量 M0 就是主线程对应的 m,G0 持有 M0 的指针,M0 里也记录着 G0 的指针,而且一开始 M0 上执行的协程正是 G0,M0 和 G0 就这样联系了起来。
全局变量 allgs 记录着所有的 g,allm 自然用于记录所有的 m。

最初 go 语言的调度模型里只有 M 和 G,所以待执行的 G 排排坐等在一处。每个 M 来这里获取一个 G 时都要加锁,多个 M 分担着多个 G 的执行任务,就会因频繁加锁解锁而发生等待,影响程序并发性能。

所以后来在 M 和 G 以外又引入了 P,P 对应的数据结构是 runtime.p,它有一个本地 runq。

这样只要把一个 P 关联到一个 M,这个 M 就可以从 P 这里直接获取待执行的 G,不用每次都和众多 M 从一个全局队列中争抢任务了。

也就是说,虽然 P 有一个本地 runq,但是依然有一个全局 runq,它保存在全局变量 sched 中,这个全局变量代表的是调度器,对应的数据结构是 runtime.schedt。这里记录着所有空闲的 m,空闲的 p 等等许多和调度相关的内容,其中就有一个全局的 runq。

如果 p 的本地队列已满,那么等待执行的 g 就会被放到这个全局队列里,而 M 会先从关联的 P 持有的本地 runq 中获取待执行的 G。如果没有的话再到调度器持有的全局队列这里领取一些任务,如果这里也没有了,就会去别的 P 那里分担一些 g 过来。

同 G 和 M 一样,也有一个全局变量用于保存所有的 P。在程序初始化过程中,会进行调度器初始化。这时会按照 GOMAXPROCS 这个环境变量决定创建多少个 P,保存在全局变量 allp 中,并且把第一个 P(即 allp[0])与 m0 关联起来。
简单来说,G、M 和 P 就是这样的合作关系,现在我们可以更清晰地理解下面这个经典的示意图了。

在 main goroutine 创建之前,GPM 的情况是这样的:

main goroutine 创建之后,被加入到当前 P 的本地队列中,然后通过 mstart 函数开启调度循环。这个 mstart 函数是所有工作线程的入口,主要就是调用 schedule 函数,也就是执行调度循环。其实对于一个活跃的 M 而言,不是在执行某个 G,就是在执行调度程序获取某个 G。我们暂且不展开调度循环的具体逻辑,反正目前面临的调度场景很简单,队列里只有 main goroutine 等待执行。

所以 m0 切换到 main goroutine,执行入口自然是 runtime.main,它会做很多事情,包括创建监控线程、进行包初始化等等,其中也包括调用我们熟悉的 main.main,现在终于可以输出 “Hello World!” 了。

值得一提的是,在 main.main 返回之后,runtime.main 就会调用 exit 函数结束进程。
接下来我们把这个 hello world 程序改造一下,如果在 main.main 中不直接输出,而是通过一个协程来输出,那么到 main.main 被调用执行时,就会创建一个新的 goroutine,我们把它记为 hello goroutine。
1 | package main |
我们通过 go 关键字创建协程,会被编译器转换为 newproc 函数调用,main goroutine 也是由 newproc 函数创建的。创建 goroutine 时,我们只负责指定入口、参数,而 newproc 会给 goroutine 构造一个栈帧,目的是让协程任务结束后返回到 goexit 函数中,进行协程资源回收处理等工作。
这很合理,一个协程在任务完成后,是该放到空闲 g 队列里备用,还是该释放,总归要有个出路。
回到 newproc 这里,如果我们设置 GOMAXPROCS 只创建一个 P,新创建的 hello goroutine 会被添加到当前 P 的 runq 中,然后 main.main 就结束返回了,再然后 exit() 函数被调用,进程就结束了。

所以 hello goroutine 它没能执行,问题就在于 main.main 返回后,exit() 函数就会被调用,直接把进程给结束掉了,没给 hello goroutine 空出调度执行的时间。
因此,要想让 hello goroutine 执行,就要在 main.main 返回之前拖延下时间。
如果使用 time.Sleep,实际上会调用 gopark 函数把当前协程的状态从 _Grunning 修改为 _Gwaiting。
1 | package main |

然后 main goroutine 不会回到当前 p 的 runq 中,而是在 timer 中等待,继而调用 schedule 进行调度,hello goroutine 得以执行。

等到 sleep 的时间到达后,timer 会把 main goroutine 重新置为 _Grunnable 状态,放回到 p 的 runq 中。

再然后 main.main 结束,exit 得以调用,从而进程退出。

这是只有一个 P 的情况,如果创建了多个 P,hello goroutine 创建之后虽然默认会添加到当前 P 的本地队列里,但是在有空闲 P 的情况下,就可以启动新的线程关联到这个空闲的 P,并把 hello goroutine 放到它的本地队列中了。

同样也可以使用 time.Sleep 或者是等待一个 channel,又或者是使用 WaitGroup,反正只要 main.main 不马上返回,hello goroutine 就有时间得以执行了。
3. Goroutine 的创建
还是这个 hello goroutine 的例子,只不过给协程入口函数增加一个参数。
1 | package main |
我们已经知道 main goroutine 执行起来会创建一个 hello goroutine,而创建的任务就交由 newproc 函数来负责。
1 | func newproc(siz int32, fn *funcval) |
我们通过函数栈帧看一下 newproc 函数的调用过程,main 函数栈帧自然分配在 main goroutine 的协程栈中。还记得 go 语言函数栈帧布局吗,call 指令入栈的返回地址之后是调用者栈基,然后是局部变量区间,以及调用其他函数时传递返回值和参数的区间。
main 函数这里有一个局部变量 name,接下来要调用 newproc 函数。从 newproc 函数签名来看,要接收两个参数,第一个是传递给协程入口函数的参数占多少字节,第二个是协程入口函数对应的 funcval 指针。
所以在参数空间这里要入栈两个参数,由右至左先入栈 fn,也就是协程入口函数 hello 对应的 funcval 指针。再入栈参数大小,一个 string 类型的参数 64 位下占 16 字节。
实际上这个要传递给协程入口函数的参数也会被放到第二个参数之后,所以局部变量 name 要拷贝到 fn 的上边,这样就好像给 newproxy 函数传递了三个参数一样。而这下面就是 call 指令入栈的返回地址,再然后就是 newproc 函数栈帧了。
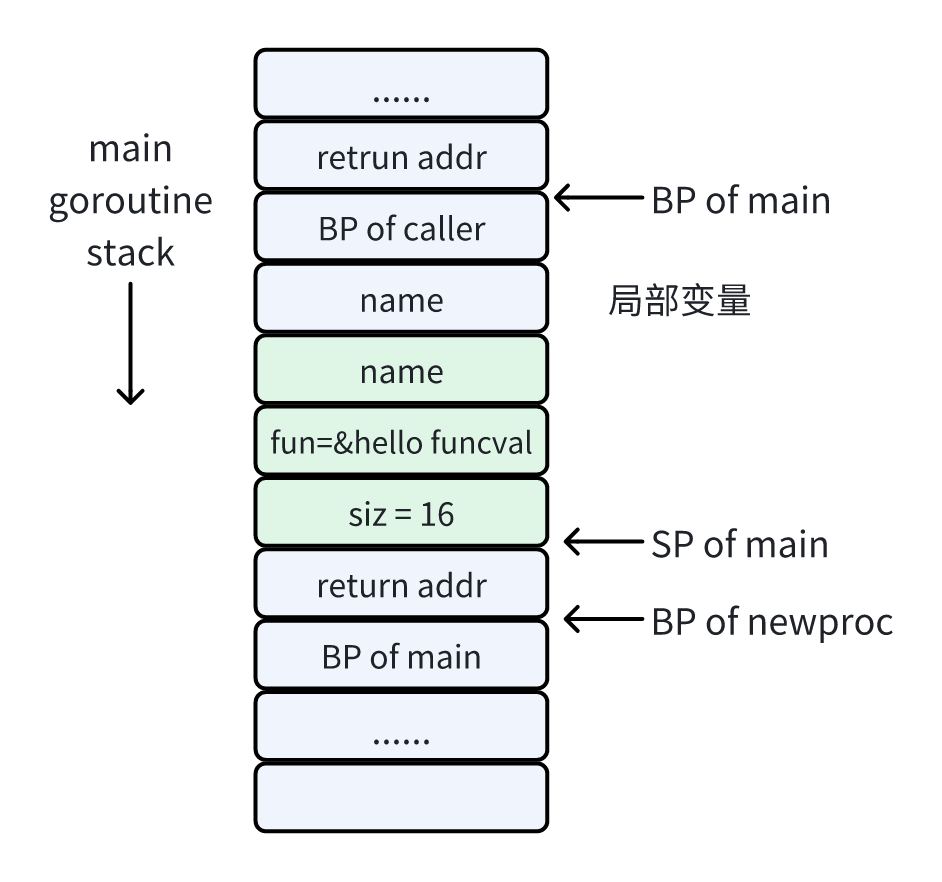
而 newproc 函数这里主要做的就是切换到 g0 栈去调用 newproc1 函数,至于为什么要切换到 g0 栈,简单来说是因为 g0 的栈空间它够大,因为 runtime 中很多函数都有 no-split 标记,意味着这个函数不支持栈增长,也就是说编译器不会在这个函数中插入栈增长相关的检测代码。
1 | func newproc(siz int32, fn *funcval) { |
协程栈本来就比线程栈小得多,这些函数自己要消耗栈空间,却又不支持栈增长,那在普通协程上执行它们,万一栈溢出了就不好了。而 g0 的栈直接分配在线程栈上,栈空间足够大,所以直接切换到 g0 栈来执行这些函数,就不用担心栈溢出的问题了。

再来看它调用 newproc1 时都传递了些什么参数,fn 和 size 不用多说,这就是 newproc 自己接收的那俩参数。而 argp 是用于正好定位到协程入口函数的参数,它在赋值时,会使用参数 fn 的地址加上一个指针大小。
第四个参数 GP 是当前协程的指针,我们的例子中 newproc 函数执行在 main goroutine 中,所以 gp 就是 main goroutine 的 g 指针。
最后一个参数 pc,在 newproc 函数中调用 getcallerpc() 得到的是 newproc 函数调用结束后的返回地址,也就是上图中 BP of newproc 指向的 return addr 的地址,即调用 newproc 函数时,由 call 指令入栈的那个返回地址。
于 newproxy1 而言,它的任务是创建一个协程,而目前已经知道新建协程入口在哪,参数在哪,占多少字节,还知道它的父协程是谁,以及创建完协程后要返回到哪去。
1 | newproc1(协程入口, 参数地址, 参数大小, 父协程, 返回地址) |
newproxy1 首先要通过 acquirem 禁止当前 m 被抢占。之所以不能被强占,是因为接下来要执行的程序中,可能会把当前 p 保存到局部变量中。若此时 m 被抢占,p 关联到别的 m,等到再次恢复时继续使用这个局部变量里保存的 p 就会造成问题。所以为了保持数据一致性,会暂时禁止 m 被抢占。
我们继续看,接下来会尝试获取一个空闲的 G,如果当前 p 和调度器中都没有空闲的 G,就创建一个并添加到全局变量 allgs 中。我们依然把这个新创建的协程记为 hello goroutine,此时它的状态是 _Gdead,而且已然拥有自己的协程栈。

接下来,如果协程入口函数有参数,就把参数移动到协程栈上。对 hello goroutine 而言,就要把这里的参数拷贝到这下面的 hello goroutine 栈中。
再然后就有点意思了,接下来会把 goexit 函数的地址加一,压入协程栈,再把 hello goroutine 对应的 g 这里,startpc 置为协程入口函数起始地址,gopc 置为父协程调用 newproc 后的返回地址。
g.sched 这个结构体用于保存现场,此时会把 g.sched.sp 置为协程栈指针,g.sched.pc 指向协程入口函数的起始地址。现在我们来看 hello goroutine 的协程栈,首先是参数,接着是返回地址,下面就是 hello 函数的栈帧。

这岂不是就像在 goexit 函数中调用了协程入口函数 hello,并且传递了用户传递的参数,而指令指针刚刚跳转到 hello 函数的入口处却还没有开始执行时的状态。
所以经这一通伪装,待到这个协程得到调度执行的时候,通过 g.sched 恢复现场,就会从 hello 函数入口处开始执行了,而 hello 函数结束后便会返回到 goexit 函数中执行协程资源回收等收尾工作。这样一来,协程该如何出场,又该如何收场就都有了着落,甚是巧妙。
不过这还没完,newproc1 还会给新建的 go routine 赋予一个唯一 id,给 g.goid 赋值前会把协程的状态置为 _Grunnable。这个状态也意味着这个 G 可以进到 run queue 里了,所以接下来会调用 runqput 把这个 G 放到当前 P 的本地队列中。

然后会判断如果当前有空闲的 p,而且没有处于 spinning 状态的 m,也就是说所有 m 都在忙,同时主协程已经开始执行了,那么就调用 wakep 函数启动一个 m,并把它置为 spinning 状态,最后与一开始的 acquirem 相呼应,会调用 releasem 允许当前 m 被抢占。
1 | sched.npidle>0 && sched.nmspinning=0 && mainstarted=true |

话说右边边,spinning 状态的 m 启动后,忙不迭地执行调度循环寻找任务。从本地 runq 到全局 runq 再到其他 p 的 runqueue,只为找到个待执行的 g,却也敌不过左边 main goroutine 早早地结束了进程。
上一小节我们使用 time.Sleep 拖延了一下 main.main 返回的时间,这一次我们通过等待一个 channel,看一下协程如何让出,又是怎样恢复的。
4. Goroutine 的让出与恢复
channel 对应的数据结构是 runtime.hchan,里面有 channel 缓冲区地址、大小、读写下标,也记录着元素类型、大小及 channel 是否已关闭,还记录着等待 channel 的那些 g 的读队列与写队列,自然也少不了保护 channel 并发操作安全的一把锁。
1 | package main |
我们这个例子中创建的是无缓冲的 channel,<-ch 这里会被编译器转换为 runtime.chanrecv1 函数调用,而它实际上会调用 runtime.chanrecv 函数,这个函数的具体逻辑我们介绍到 channel 时再展开,目前只关注我们的例子会涉及到的一小部分。
ch 没有缓冲区,目前也没有哪个 g 等在 sendq 中,简言之,没数据可读。所以当前 goroutine 会阻塞在 ch 这里等待数据,当前 goroutine 自然是 main goroutine。
而 channel 的读等待队列是一个 sudog 类型的链表,链表项会记录哪个 g 等在这里,读到数据后要放到哪里等等。然后 chanrecv 通过 gopark 函数使当前 goroutine 挂起,让出 CPU。

gopark 首先会调用 acquirem,禁止当前 m 被抢占,然后把 main goroutine 的状态从 _Grunning 修改为 _Gwaiting,main goroutine 不再是执行中的状态了,接下来调用 release m 解除 m 的抢占禁令。
最后调用 mcall(park_m),它主要负责保存当前协程的执行现场,然后切换到 g0 栈,调用 mcall 参的数传入的这个函数,对应到这里就是 park_m 函数, park_m 会根据 g0 找到当前 m,把 m.curg 置为 nil,所以当前 m 正在执行的 g 便不再是 main goroutine 了,最后会调用 schedule() 函数寻找下一个待执行的 g。
1 | // 让出 |
经过上面这一番折腾,hello goroutine 无论是得到当前 m 的调度,还是是被其他 m 抢了过去,总之是可以执行了。等到 hello goroutine 完成工作,关闭 main goroutine 等待的 channel 时,不止会修改 channel 的 closed 状态,还会处理等待队列里的这些 g。
我们这个例子只在读队列里有一个 main goroutine 在等待,所以会把它接收的数据置为 nil,并最终调用 goready 函数结束这个 g 的等待状态,而 goready 函数会切换到 g0 栈并执行 runtime.ready 函数。

目前带 ready 的协程自然是 main goroutine,此时它的状态是 _Gwaiting,接下来会被修改为 _GRunnable,表示它又可以被调度执行了。然后它会被放到当前批的本地 runq 中,同协程创建时一样,接下来也会检查是否有空闲的 p,并且没有 spinning 状态的 m。如果校验为是的话,也会调用 weakp() 函数启动新的 m。
1 | // 恢复 |

接下来 hello goroutine 结束,main goroutine 得到调度执行,最终结束进程。

这样看来,time.Sleep 和 channel 底层都会调用 gopark 来实现协程让出,也都会使用 goready 把协程恢复到 Runnable 状态并返回到 runq 中。
5. Goroutine 的抢占、监控和调度
5.1 主动让出
我们已经知道协程执行 time.Sleep 时,状态会从 _Grunning 变为 _Gwaiting 并进入到对应 timer 中等待。而 timer 中持有一个回调函数,在指定时间到达后调用这个回调函数,把等在这里的协程恢复到 _Grunnable 状态,并放回到 runq 中。
那谁负责在定时器时间到达时触发定时器注册的回调函数呢?其实每个 P 都持有一个最小堆,存储在 P.timers 中,用于管理自己的 timer,堆顶 timer 就是接下来要触发的那一个,而每次调度时都会调用 checkTimers 函数检查并执行已经到时间的那些 timer。

不过这还不够稳妥,万一所有 M 都在忙,不能及时触发调度的话,可能会导致 timer 执行时间发生较大的偏差,所以还会通过监控线程来增加一层保障。
在介绍 HelloGoroutine 的执行过程时,我们提过监控线程是由 main goroutine 创建的。这个监控线程与 GPM 中的工作线程不同,并不需要依赖 P,也不由 GPM 模型调度,它会重复执行一系列任务,只不过会视情况调整自己的休眠时间。其中一项任务便是保障 timer 正常执行,监控线程检测到接下来有 timer 要执行时,不仅会按需调整休眠时间,还会在空不出 M 时创建新的工作线程,以保障 timer 可以顺利执行。
当协程等待一个 channel 时,其状态也会从 _Grunning 变为 _Gwaiting,并进入到对应 channel 的读队列或写队列中等待。如果协程需要等待 IO 事件,就也需要让出。以 epoll 为例,若 IO 事件尚未就绪,需要注册要等待的 IO 事件到监听队列中。而每个监听对象都可以关联一个 event data,所以就在这里记录是哪个协程在等待,等到事件就绪时再把它恢复到 runq 中即可。

不过 timer 计时器有设置好的触发时间,等待的 channel 可读、可写或关闭了,也自会通知到相关协程。而获取就绪的 IO 事件需要主动轮询,所以为了降低 IO 延迟,需要时不时的轮询那么一下,也就是执行 netpoll(主动轮询)。

实际上监控线程调度器、 GC 等工作过程中都会按需执行 netpoll,全局变量 sched 中会记录上一次 netpoll 执行的时间,监控线程检测到距离上次轮询已经超过 10 毫秒,就会再执行一次 netpoll。
5.2 抢占策略
上面说的无一例外都是协程会主动让出的情况,那要是一个协程不会等待 timer、channel 或者 IO 事件,那就不用让出了吗?那必须不能,否则调度器岂不成了摆设?那怎么让那些不用等待的协程让出呢?
这就是监控线程的另一个工作任务了,那就是本着公平调度的原则,对运行时间过长的 P 实行抢占操作。
也就是告诉那些运行时间超过特定阈值的 G 该让一让了,那怎么知道运行时间过长呢?
P 里面有一个 schedtick 字段,每当调度执行一个新的 G 并且不继承上个 G 的时间片时,就会把它自增一,而这个 p.sysmontick 中的 schedwhen 记录的是上一次调度的时间:
- 监控线程如果检测到 sysmontick.schedtick 与 p.schedtick 不相等,说明这个 P 又发生了新的调度,这时就会同步这里的调度次数,并更新这个调度时间。
- 但是若二者相等,那说明自 schedwhen 这个时间点之后,这个 P 并未发生新的调度,或者即使发生了新的调度,也沿用了之前 G 的时间片。
所以可以通过当前时间与 schedwhen 的差值,来判断当前 P 上的 G 是否运行时间过长了。

那如果真的运行时间过长了,要怎么通知它让出呢?这就不得不提到栈增长了,除了对协程栈没什么消耗的函数调用,go 语言编译器都会在函数头部插入栈增长相关代码。实际上编译器插入的栈增长代码一共有三种:
- 栈帧比较小(framesize <= _StackSmall)
那么插入的代码就是这样的:
1 | gp := getg() |
这个 SP 表示当前协程栈使用到了什么位置,stackguard0 就是协程栈空间下界,所以当协程栈的消耗达到或超过这个位置时,就需要进行栈增长了。
- 栈帧大小处在中间位置(_StackSmall < framesize <= _StackBig)
那么插入的代码就是这样的:
1 | gp := getg() |
也就是说当前协程栈使用到 stackguard0 这里了,若再使用 framesize 这么多,超出 stackguard0 的部分大于 _StackSmall 了,此时就要进行栈增长了。
- 栈帧大小超过 StackBig(framsize > _StackBig)
那么插入的代码就又有所不同了:
1 | gp := getg() |
判断是否要栈增长的方式本质上与第二种情况相同,而我们要关注的是这里的 stackPreempt,它是和协程调度相关的重要标识,当 runtime 希望某个协程让出 CPU 时,就会把它的 stackguard0 赋值为 stackPreempt。这是一个非常大的值,真正的栈指针不可能指向这个位置,所以可以安全地用作特殊标识。
正因为 stackPreempt 这个值足够大,所以上面两段代码中的判断结果也都会为 true,进而跳转到 more Stack 处,而 morestack 这里最终会调用 runtime.newstack 函数,它实际负责栈增长工作。不过它在进行栈增长前会先判断 stackguard0 是否等于 stackPreempt,等于的话就不进行栈增长了,而是执行一次协程调度。
所以在协程不主动让出时,也可以设置 stackPreempt 标识通知它让出。不过这种抢占方式的缺陷就是过于依赖栈增长代码,如果来个空的 for 循环,因为与栈增长无关,监控线程等也无法通过设置 stackPreempt 标识来实现抢占,所以最终导致程序卡死。
1 | func main() { |
这一问题在 1.14 版本中得到了解决,因为它实现了「异步抢占」。具体实现在不同平台中不尽相同,例如在 Unix 平台中会向协程关联的 M 发送信号(sigPreempt),接下来目标线程会被信号中断,转去执行 runtime.sighandler,在 sighandler 函数中检测到信号为 sigPreempt 后,就会调用 runtime.doSigPreempt 函数,它会向当前被打断的协程上下文中注入一个异步抢占函数调用。
处理完信号后,sighandler 返回,被中断的协程得到恢复,立刻执行被注入的异步抢占函数,该函数最终会调用 runtime 中的调度逻辑,这就成功让出了。所以在 1.14 版本中,上面这段代码执行起来就不会卡死了。
因此监控线程的抢占方式又多了一种方式,即异步抢占。其实为了充分利用 CPU,监控线程还会抢占处在系统调用中的 P,因为一个协程要执行系统调用,就要切换到 g0 栈。在系统调用没执行完之前,这个 M 和这个 G 算是抱团了,不能被分开,也就用不到 P,所以在陷入系统调用之前,当前 M 会让出 P,解除 M 点 P 与当前 P 的强关联,只在 m.oldp 中记录这个 P。
P 的数目毕竟有限,如果有其他协程在等待执行,那么放任 P 如此闲置就着实浪费了,还是把它关联到其他 M 继续工作比较划算。
不过,如果当前 M 从系统调用中恢复,会先检查之前的 P 是否被占用,没有的话就继续使用,否则再去申请一个。没申请到的话就把当前 G 放到全局 ranq 中去,然后当前线程就睡眠了。
说了这么多,不是让出就是抢占,那让出了抢占了之后 M 也不能闲着,得找到下一个待执行的 G 来运行,这就是 schedule() 的职责了。schedule 这里要给这个 M 找到一个待执行的 G,首先要确定当前 M 是否和当前 G 绑定了:
- 如果绑定了,那当前 M 就不能执行其他 G,所以需要阻塞当前 M,等到当前 G 再次得到调度执行时,自会把当前 M 唤醒。
- 如果没有绑定,就先看看 GC 是不是在等待执行,全局变量 sched 的这里有一个 gcwaiting 标识。
- 如果 GC 在等待执行,就去执行 GC,回来再继续执行调度程序,接下来还会检查一下有没有要执行的 timer。
- 调度程序还有一定的几率会去全局 ranq 中获取一部分 G 到本地 ranq 中,而获取下一个待执行的 G 时,会先去本地 runq 中查找,没有的话就调用 findrunnable(),这个函数直到获取到待执行的 G 才会返回。
- 在 findrunnable 函数这里也会判断是否要执行 GC,然后先尝试从本地 runq 获取,没有的话就从全局 runq 获取一部分。如果还没有就先尝试执行 netpoll,恢复那些 IO 事件已经就绪了的 G,它们会被放回到全局 runq 中,然后才会尝试从其他 P 那里 steal 一些任务。
当调度程序终于获得一个待执行的 G 以后,还要看看人家有没有绑定的 M:
- 如果有的话,还得乖乖地把 G 还给对应的 M,而当前 M 就不得不再次进行调度了。
- 如果没有绑定的 M,就调用 execute 函数在当前 M 上执行这个 G。
execute 函数,这里会建立当前 M 和这个 G 的关联关系,并把 G 的状态从 _Grunnable 修改为 _Grunning。如果不继承上一个执行中协程的时间片,就把 P 这里的调度计数加一。最后会调用 gogo 函数,从 g.sched 这里恢复协程栈指针、指令指针等继续执行。
之前介绍过,协程创建时会伪造一个执行现场存到 g.sched 中,所以即使这个 G 初次执行,也是有一个完美的执行现场的。