
Golang-11:内存回收 GC 详解

1. 快速了解
在 Go 语言中,GC 即垃圾回收(Garbage Collection),是一种自动内存管理机制。它就像是一个 “ 内存清理工 “,专门负责回收程序中不再使用的内存空间,让这些空间可以被重新利用,以确保程序能够高效、稳定地运行。
2. 内存回收的由来
从进程虚拟地址空间来看,程序要执行的指令在代码段,全局变量、静态数据等都会分配在数据段。而函数的局部变量、参数和返回值都可以在函数栈帧中找到,但是由于函数调用栈会在函数返回后销毁,如果不能在编译阶段确定数据对象的大小,或者对象生命周期会超出当前所在函数,那就不适合分配在栈上,而应该分配在堆上。
随着程序的运行,有些数据便不会再用到了,直接分配在栈上的数据会随着函数调用栈的销毁,释放自身占用的内存。而这些在堆上分配的数据就不一样了,它们占用的内存需要程序 「主动释放」 才可以重新使用,否则就会成为垃圾,而越积越多的垃圾会不断地消耗系统内存。
有些编程语言需要程序员在编写程序时,手动释放那些不再需要的分配在堆上的数据,这被称为 「手动垃圾回收」 。但是一旦释放得早了,后续对该数据的访问就会出错,因为被释放的内存可能已经被清空或重新分配,甚至已经还给操作系统,这就是所谓的 「悬挂指针问题」。而如果忘了释放,它又会一直占用内存,出现 「内存泄漏」。

所以越来越多的编程语言支持 「自动垃圾回收」,由运行时识别不再有用的数据,并释放它们占用的内存。内存何时被释放的内存、被释放的内存如何处理等这些问题都不用我们操心,的确很方便。那么自动垃圾回收要怎么区分哪些数据对象是垃圾呢?
3. 内存回收算法
还得从虚拟地址空间来看,可以确定的是程序中用得到的数据一定是从栈、数据段这些根节点追踪得到的数据。虽然能够追踪得到,不代表后续一定会用到,但是从这些根节点追踪不到的数据就一定不会被用到,也就一定是垃圾。
3.1 标记清扫法
所以目前主流的垃圾回收算法都是使用 「可达性」 近似等价于 「存活性」,要识别存活对象,可以把栈、数据段上的数据对象作为 root,基于它们进一步追踪,把能追踪到的数据都进行标记,剩下的追踪不到的就是垃圾了,这就是「标记清扫算法」的核心思想

三色抽象就可以清晰地展现追踪式垃圾回收过程中对象状态的变化过程,垃圾回收开始时所有数据都为白色,然后把直接追踪到的 root 节点都标记为灰色,代表基于当前节点展开的追踪还未完成。当基于某个节点的追踪任务完成后,便会把该节点标记为黑色,表示它是存活数据,而且无需基于它再次进行追踪了。

基于黑色节点找到的所有节点都被标记为灰色,表示还要基于它们进一步展开追踪。当没有灰色节点时,就意味着标记工作可以结束了。此时有用数据都为黑色,垃圾都为白色,接下来回收这些白色对象的内存即可。

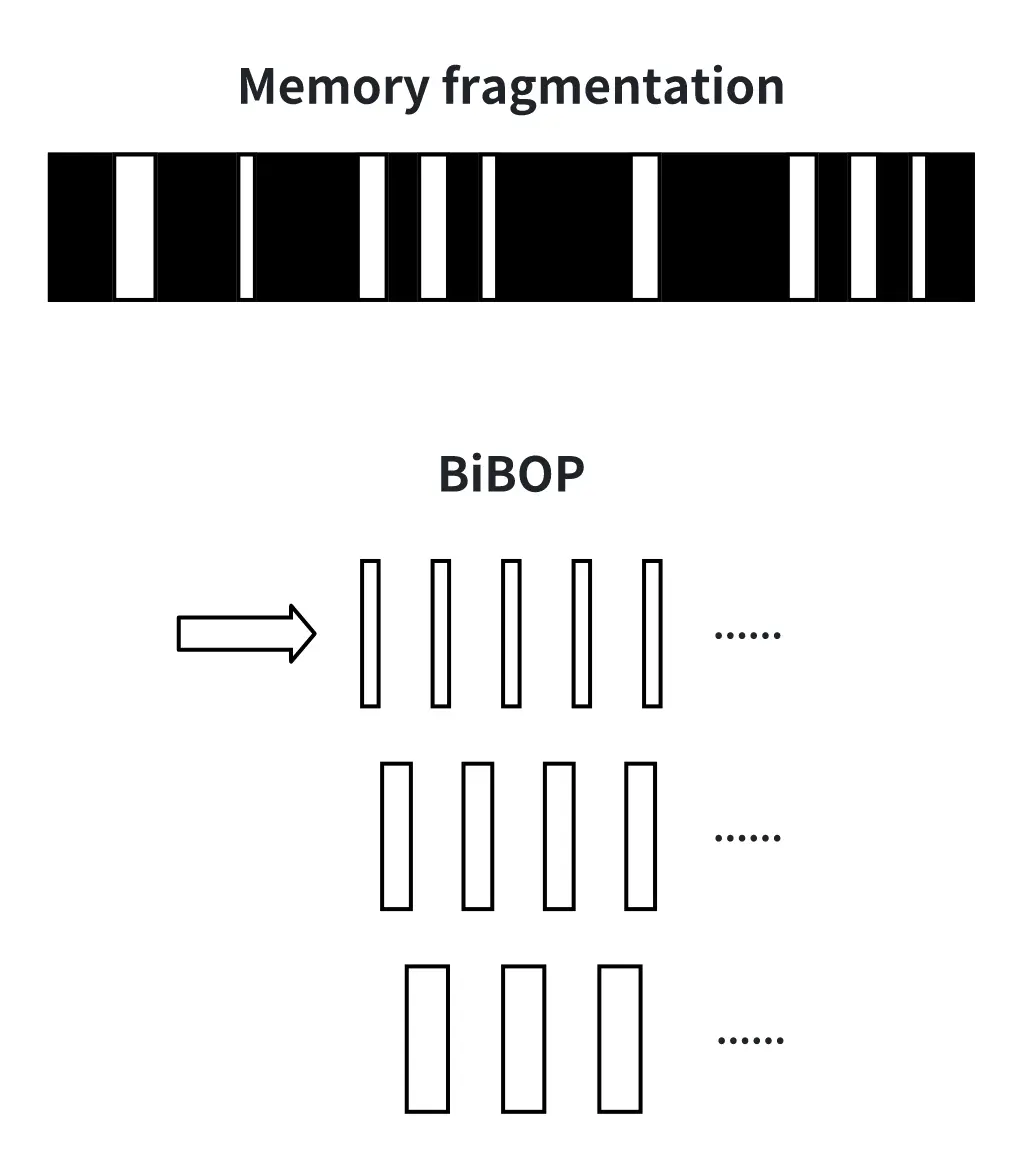
标记清扫算法实现起来相对简单,但是比较容易造成内存碎片化。而面对大量不连续的小分块内存,要找到合适的内存分块的代价更高,也会造成很多小块内存无法使用的情况。
这一问题可以基于 BiBOP(Big Bag Of Pages)的思想,把内存块划分为多种大小规格,对相同规格的内存块进行统一管理,这样可以更快地匹配到大小合适的空闲内存,规格类型划分的合理也有助于提高内存使用率。
3.2 标记整理法
除此之外,还有人提出通过移动数据来减少碎片化的方法,例如在标记整理算法中,标记阶段与标记清扫算法相同,但是会在完成标记工作后移动非垃圾数据,使它们尽可能紧凑地放在内存中。虽然标记整理算法有效解决了内存碎片化的问题,但是带来的多次扫描与移动开销也不容小觑。

3.3 复制式回收法
还有一种复制式回收算法也会移动数据,它会把堆内存划分成两个相等的空间:From 和 To,程序执行时使用 From。From 空间垃圾回收执行时会扫描 From 空间,把能追踪到的数据复制到 To 空间。当所有有用的数据都复制到 To 空间后,把 From 和 To 空间的角色交换一下,原来的 To 空间用作 From,原来的 From 空间则可以全部回收作为新的 To 空间。

这种复制式回收也不会带来碎片化问题,但是只有一半的堆内存可以被使用。为了提高对内存的使用率,通常会和其他垃圾回收算法搭配使用,只在一部分堆内存中使用复制式回收,例如在分代回收中就经常搭配使用复制式回收。
3.4 分代回收法
分代回收的提出主要是基于弱分代假说,大部分对象都会在年轻时死亡。如果我们把新创建的对象称为 「新生代对象」,把经受住特定次数的 GC 而依然存活的对象称为 「老年代对象」。基于弱分代假说,大部分对象会在最初经历的垃圾回收中死亡。
也就是说,新生代对象成为垃圾的概率高于老年代对象,所以可以把数据划分为新生代和老年代,降低老年代执行垃圾回收的频率,不用每次都处理所有数据,将明显提升垃圾回收执行的效率。而且新生代和老年代还可以分别采用不同的回收策略,进一步提升回收效益并减少开销。

3.5 引用计数法
到目前为止,我们介绍的多为追踪式回收,需要扫描堆内存来识别垃圾对象,而引用计数式垃圾回收则有所不同。引用计数指的是一个数据对象被引用的次数,程序执行过程中会更新对象的引用计数,当引用计数更新为 0 时,就表示这个对象不再有用,可以回收它占用的内存了。所以在引用计数法中,垃圾识别的任务已经分摊到每一次对数据对象的操作中了。

虽然引用计数法可以及时回收无用内存,但是高频率的更新引用技术也会造成不小的开销。而且若是 a 引用了 b,b 也引用了 a,形成循环引用。当 a 和 b 的引用计数更新到只剩彼此的相互引用时,引用计数便无法更新到 0,也就不能回收对应的内存了。

4. 增量式垃圾回收
到目前为止,我们的介绍还都是在暂停用户程序,只专注于进行垃圾回收的前提下展开的,也就是所谓的 STW(stop the world)。这首当其冲的问题就是,用户程序可以接受长时间的暂停吗?
实际上我们总是希望能够尽量缩短暂停的时间,可以将垃圾回收工作分多次完成,也就是用户程序与垃圾回收交替执行。这被称为 「增量式垃圾回收」,可以缩短每次暂停的时间,但是这也带来了额外的问题,交替执行的过程中保不齐垃圾回收程序前脚刚标记了一个黑色对象,用户程序后脚又修改了它,要是放任不管,垃圾回收程序就会把存活数据误判为垃圾。
这里我们要再次用到三色抽象了,因为它不仅可以简洁地展示追踪式垃圾回收的推进过程,还可以帮助推演回收期的正确性。在三色抽象中,黑色对象已经处理完毕,不会被再次扫描,而灰色对象还会被回收器继续处理。所以若出现黑色对象到白色对象的引用,同时没有任何灰色对象可以抵达这个白色对象,它就会被判定为垃圾,但实际上它应该是存活数据。
三色抽象清晰地描述了垃圾回收中把存活对象误判为垃圾的情况。
- 如果能够做到不出现黑色对象到白色对象的引用,就必然不会出现这样的错误了,这被称为 「强三色不变式」。
- 若把条件放宽一点,允许出现黑色对象到白色对象的引用,但是可以保证通过灰色对象可以抵达该白色对象,就也可以避免错误的回收,这被称为 「弱三色不变式」。
实现强弱三色不变式的通常做法是建立读写屏障,写屏障会在写操作中插入指令,目的是把数据对象的修改通知到垃圾回收器,所以写屏障通常都要有一个记录集。而记录集是采用顺序存储还是使用哈希表,记录精确到被修改的对象还是只记录其所在的页等问题,就是写屏障的具体实现要考虑的了。
- 「强三色不变式」 提醒我们关注白色指针,向黑色对象的写入操作,无论如何不允许出现黑色对象到白色对象的引用。因此可以把白色指针置为灰色,也可以把写入的黑色对象退回到灰色,这些都属于 「插入写屏障」。
- 「弱三色不变式」 则提醒我们关注对那些到白色对象路径的破坏行为,例如要删除灰色对象到白色对象的引用时,可以把白色对象着为灰色,这种写屏障属于 「删除写屏障」。

再来看看读屏障,非移动式垃圾回收器中天然的不需要读屏障,但如果像复制式回收器这样会移动数据来避免碎片化,那么 GC 和用户程序交替执行时,读数据便也不那么安全了。
例如回收器已经把 a 复制到 To 空间去了,之后交替执行的用户程序却读取了 From 空间中的陈旧对象,而回收器后续复制 b 到 To 空间时, b 的新副本持有的便是 a 的陈旧对象指针。当 From 空间整体被回收,对原 From 空间中 a 的访问便会出错。这种情况下就要建立读屏障,确保用户程序不会访问到已经存在新副本的陈旧对象。例如在检测到引用对象已经存在新副本时,转而读取 To 空间的新副本。
5. 并行/并发垃圾回收
至此,我们的讨论都还没有超出单核的范畴,而实际应用中不得不考虑多核的场景,暂停用户程序的前提下,多线程并行执行垃圾回收程序,这被称为 「并行垃圾回收」 。原本由一个线程全权负责的任务,现在需要分几份交给多个线程,那么分工不均就会导致有的线程忙死,有的线程闲死,而实现较好的负载均衡却会增加线程间的同步开销。
并行场景下,同步似乎是不可回避的问题,否则就连一轮垃圾回收何时结束也很难愉快地决定。有些垃圾回收器在并行场景下还得规避重复处理数据的问题。例如复制式回收期在并行场景下,必须要避免数据对象被不同线程重复复制,否则可能造成数据不一致。
并发垃圾回收指的是用户程序与垃圾回收程序并发执行,在多核场景下就会存在用户程序和垃圾回收程序并行执行的情况。这和并行垃圾回收中只考虑垃圾回收程序的并行执行是不同的。就拿写屏障来说,多核并发场景下,用户程序和回收器可能会同时使用写屏障记录器,所以并发写屏障的设计还要考虑到用户程序之间以及与垃圾回收程序之间的竞争问题。
如果没有任何 STW 的事件,那么垃圾回收开始的消息便很难准确、及时地通知到所有线程,可能导致某些线程开启写屏障的动作有所延迟而发生错误。所以实际应用中在某些阶段采取 STW 的方式,在其他阶段支持并发的 「主体并发式垃圾回收」 更容易实现。若在此基础上再支持增量式回收,那便属于 「主体并发增量式回收」。

6. 问题解决
go 语言的 GC 在准备阶段会为每个 P 创建一个 mark worker 协程,把对应的 g 指针存储到 P 中。这些后台 mark worker 创建后很快陷入休眠,等待到标记阶段得到调度执行。

接下来第一次 STW,GC 进入 _GCMark 阶段:
- 全局变量 gcphase 记录 GC 阶段标识
- 全局变量 writeBarrier 记录是否开启写屏障
- 全局变量 gcBlackenEnabled 用于标识是否允许进行 GC 标记工作,将它置为 1 表示允许
在 STW 的情况下开启写屏障,等所有准备工作做好以后,start the world 所有 P 都会知道写屏障已经开启,然后这些后台 mark worker 可以得到调度执行,展开标记工作。
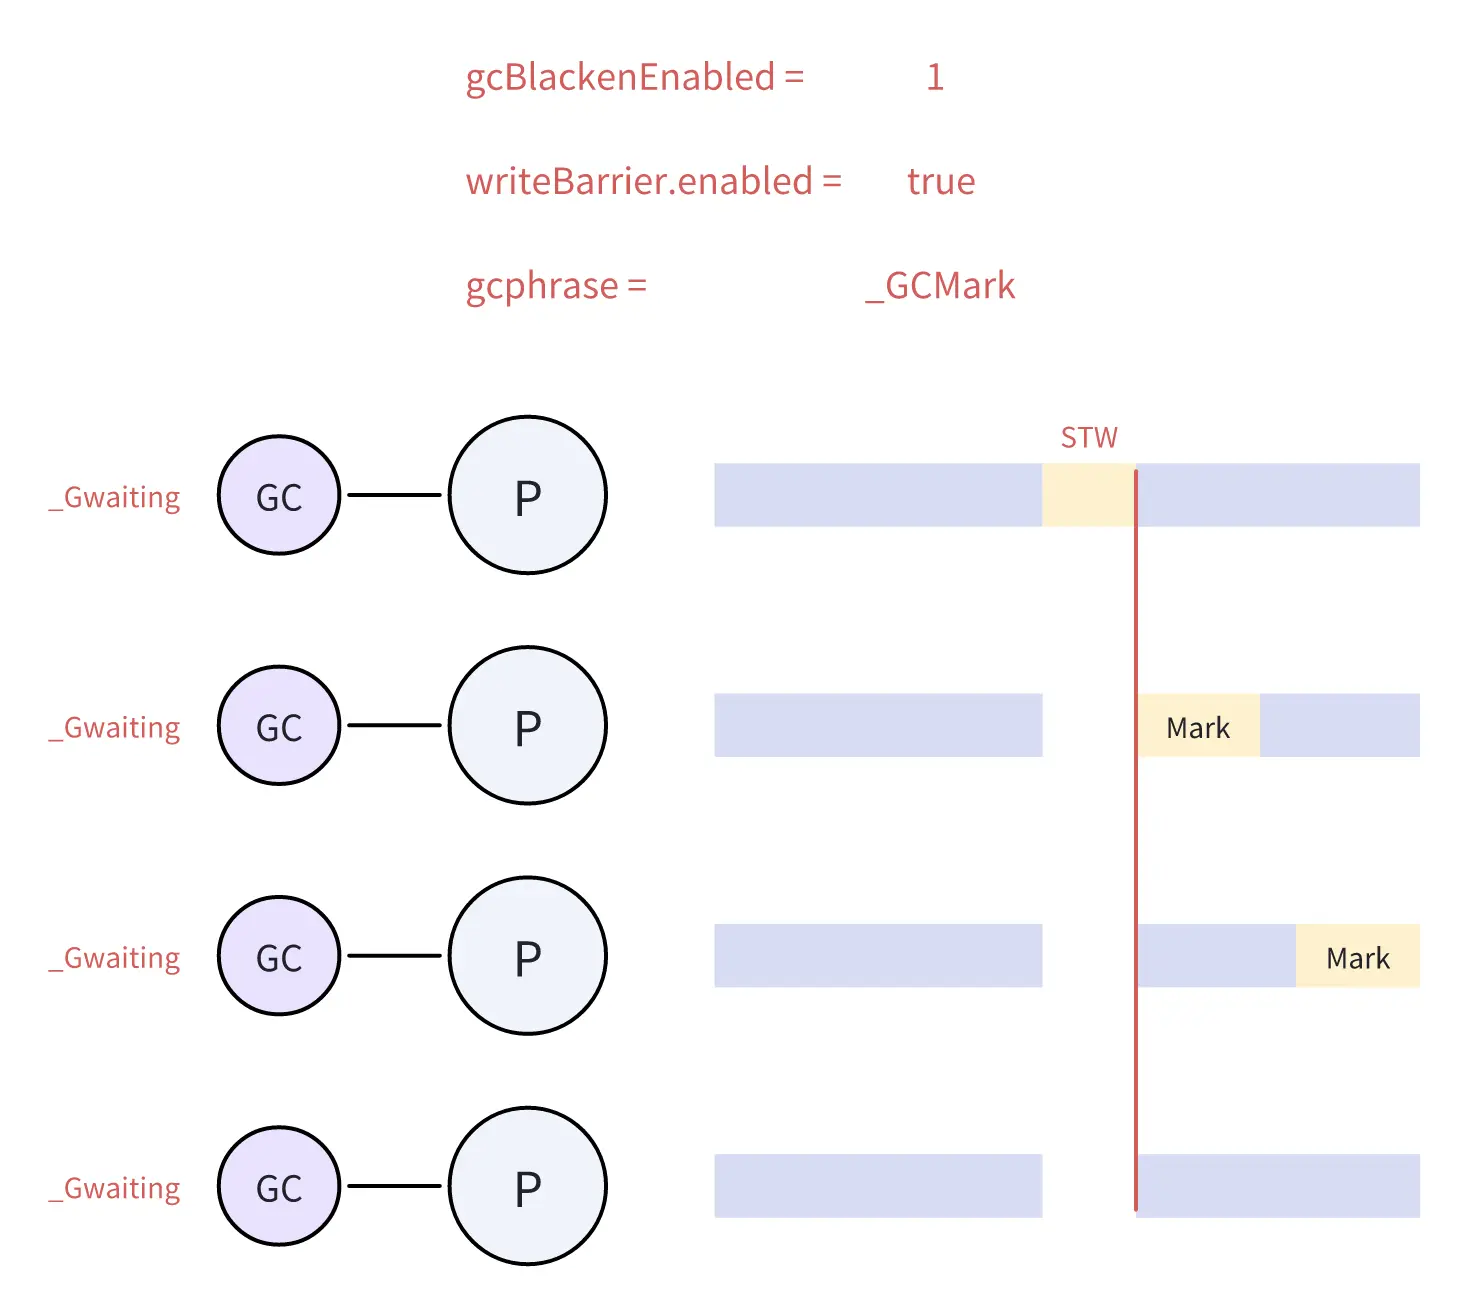
当没有标记任务时,第二次 STW,GC 进入 _GCMarkTermination 阶段,确认标记工作确实已经完成,然后停止标记工作,将 gcBlackenEnabled 置为 0。
接下来进入 _GCOff 阶段,关闭写屏障, start the world 进入清扫阶段。进入 _GCOff 阶段之前,新分配的对象会直接标记为黑色。进入 _GCOff 阶段之后,再新分配的对象就是白色的了。

执行清扫工作的协程由 runtime.main 在 gcenable 中创建,对应 g 指针存储在全局变量 sweep 中。到清扫阶段,这个后台的 sweeper 会被加入到 runq 中,它得到调度执行时会执行清扫任务。因为清扫工作也是增量进行的,所以每一轮 GC 开始之前,还要先确保完成上一轮 GC 未完成的清扫工作。

这样大致看下来,似乎只是有两次必要的 STW 标记与清扫工作并发增量执行的 GC 而已,下面我们重点关注几个问题。
6.1 Mark
在 GC 标记工作中,如何确定 BSS 段、数据段以及协程栈上的 root 节点数据对象是否是 GC 感兴趣的指针,以及这些指针是否指向堆内存?
第一个问题关乎 GC 标记工作,依照标记清扫算法,标记工作要从扫描 BSS 段、数据段以及协程栈上的这些 root 节点开始,追踪到堆上的节点。那怎么确定这些数据对象是否是 GC 感兴趣的指针呢?
go 语言在编译阶段会生成 BSS 段、数据段等对应的元数据,存储在可执行文件中。通过各模块对应的 modeldata 可以获得 gcdatamask、gcbssmask 等信息,它们会被用于判断特定 root 结点是否为指针。
协程栈也有对应的元数据存储在 stackmap 中,扫描协程栈时,通过对应元数据可以知道栈上的局部变量、参数、返回值等对象中哪些是存活的指针。
确定了 root 节点是否为指针,还要再进一步判断这些指针是否指向堆内存。如果指向堆内存,就得把它们加入到 GC 工作队列中进行进一步的扫描。堆上这些数据对象自然也有对应的元数据,但我们首先要了解下堆内存大致是什么结构。
mheap 管理着虚拟地址空间中一大段连续的内存,通常所谓的从堆内存分配就是指从这里分配,这段内存以 8K 为一页,多个页组成一个 span,多个 span 组成一个 arena。span 对应的数据结构是 mspan,每个 span 都只存储一种大小的元素。
- span 存储元素的大小规格覆盖了小于等于 32K 的 66 种大小,对应编号 1 ~ 66,记录在 mspan.spanclass 中。
- 大于 32K 的大对象直接在 mheap 中分配,对应 spanclass 记录的编号为 0,这样一共有 67 种。

除了会按存储元素大小对 span 进行分类以外,还会同时按照存储元素是否含有指针来分类。这一分类信息也存储在 spanclass 中,所以元素大小类型相同的 span 还会分为两种,含有指针的属于 scan 类型,不含指针的属于 no-scan 类型,最终 span 分类一共有 67 乘以 2 = 134 种。

分配内存时怎么确定是否含有指针呢?每种类型元数据都有一个 ptrdata 字段,根据它可以决定数据对象应该分配到哪种 span 中。
- 例如一个 uintptr 类型的对象 a,对应类型元数据中 ptrdata 等于 0,所以会被分配到 noscan 类型的 span 中,nonscan 类型的 span 不会被 GC 扫描。即使 a 存储的是堆上某个对象的地址,这个对象也不会被垃圾回收追踪到。
- 而指针类型对应的元数据中,ptrdata 不等于 0,会被分配到 scan 类型的 span 中,这类 span 会被 GC 扫描。
如果协程都直接向 mheap 申请内存,那么同步开销就太大了,所以 go 语言实现了全局与本地 span 缓存, mheap.central 提供全局 span 缓存,按照 spanclass 类型区分,共 134 个 mcentral,每个 mcentral 管理一种类型的 mspan,并且会将有空闲空间和没有空闲空间的 mspan 分别管理,每个 P 都有一个 mcache 用作本地 span 缓存。同样按照 spanclass 类型区分共 134 个 mspan 链表。

堆内存管理结构大致如此,接下来就看看有哪些 GC 标记用得到的元数据信息。
mheap 中每个 hrena 对应一个 HeapArena 记录 arena 的元数据信息,其中有一个 bitmap,bitmap 中一个字节可以标记 arena 中连续四个指针大小的内存。每个 word 对应的两个比特中:
- 低位比特用于标记是否为指针,0 为非指针,1 为指针。
- 高位比特用于标记是否需要继续扫描,高位比特为 1 就代表扫描完当前 word,并不能完成当前数据对象的扫描。
bitmap 的信息在分配内存时设置,会用到对应类型元数据中的 gcdata 信息。 HeapArena 中还有一个 span 字段,它是一个新的 mspan 类型的数组,用于记录当前 arena 中每一页对应到哪一个 span。基于 HeapArena 记录的元数据信息,我们只要知道一个对象的地址,就可以根据 bitmap 信息扫描它内部是否含有指针。
也可以根据对象地址计算出它在哪一页,然后通过 span 信息查到该对象存在哪一个 span 中,而每个 span 都对应两个位图标记记录在 mspan 中。
allocBits 中每一位用于标记一个对象存储单元是否已分配,gcmarkBits 中每一位用于标记一个对象是否存活。有了这些元数据和位图标记,我们就能知道哪些数据对象应该被标记为灰色,也就是把其对应的 gcmarkBits 标记为 1,并把它加入到工作队列中。
6.2 Gcw & wbBuf
分配内存时怎样确定数据对象是否含有指针,以及如何避免协程直接向 mheap 申请内存带来的同步开销过大问题?
依据每种类型元数据中的 ptrdata 字段确定:
- predata 等于 0(如 uintptr 类型对象)对应的数据对象会被分配到 no scan 类型的 span 中,该类型 span 不会被 GC 扫描;
- ptrdata 不等于 0 的指针类型对应的数据对象会被分配到 scan 类型的 span 中,会被 GC 扫描。
go 语言实现了全局与本地 span 缓存,mheap 的 central 提供全局 span 缓存(按 spanclass 类型区分共 134 个 mcentral,分别管理一种类型的 m pan,并区分有空闲空间和无空闲空间的 mspan),每个 p 都有一个 mcache 用作本地 span 缓存(同样按 spanclass 类型区分共 134 个 mspan 链表堆)。

6.3 CPU Utilization
GC 初始化创建的 Mworker 在调度时启动数量如何确定,怎样控制 GC 对 CPU 的使用率,以及解决计算启动数量时产生的误差问题?
GC 在初始化阶段根据当前 gcmaxprocs 数值乘以 CPU 目标使用率(默认 25%)计算需要启动的 mockworker 数量,对计算结果进行加 0.5 的 rounding 处理。引入不同工作模式,dedicated 模式的 worker 执行标记任务直到被抢占,fractional 模式的 worker 除被抢占外,还能在达到 fractional 部分目标时主动让出。
全局变量 gcController 记录可启动的 dedicated 模式 worker 数量和 fractional utilization goal,调度器根据 dedicated 模式 worker 数量是否达到上限,决定设置为 dedicated 模式或在需要时设置为 fractional 模式。
P 记录累计执行 fractional worker 的时间与当前 worker 开始工作的时间,gcController 记录本轮 GC 标记工作开始的时间,通过检查当前批累计在 fractional 模式下的工作时间与本轮 GC 标记工作已执行时间的比率是否达到 fractional utilization goal,控制 worker 是否让出,从而控制 CPU 使用率。
6.4 Memory Alloc
如何避免 GC 执行过程中内存分配压力过大,以及协程和后台 Markworker 在内存分配时与 GC 相关的工作和债务如何处理?
实现 GC assist 机制,协程分配内存且 GC 标记工作未完成时,按申请内存大小负担相应标记工作(借贷偿还机制)。当前 g 中 GC assist bytes 小于 0 时负债,大于 0 时有结余,负债的 g 申请内存前需辅助 GC 完成标记工作偿还债务。
后台 mark worker 每完成一定量标记任务在全局 gcController 存信用,有债务的 g 可从 gcController steal 信用抵消债务,结余可用于下次内存分配。GC 标记阶段检查是否需辅助标记,清扫阶段如直接从 mmap 分配大对象或从本地缓存分配 span 时遇到未清扫情况,可能触发辅助清扫,避免内存分配压力过大导致 GC 来不及回收。
6.5 Hybrid Barrier
在 go 语言中,引入混合写屏障前存在写屏障代价大以及第二次 STW 时重新扫描协程栈时间长的问题,如何解决?
整合插入与删除写屏障为混合写屏障,忽略协程栈上的协程屏障,只在标记结束阶段重新扫描被激活的栈帧。
利用删除写屏障保障写入栈上的数据对象不会被 hiding(在删除可达路径时标记对象为灰色),利用插入写屏障避免将白色对象写入堆上的黑色对象(写入时标记新指针)。
判断当前栈是否为灰色,若为已完成扫描的黑色栈则无需插入写屏障再标记,通过这种方式既可以忽略当前栈帧的写屏障,也不用在第二次 STW 时重新扫描所有活跃 g 的栈帧。