
Golang-05:闭包 & defer 详解

1. 闭包详解
1.1 快速了解
在 Go 语言中,闭包是一个函数值,它引用了其函数体之外的变量。闭包能够访问和操作在其定义的上下文中存在的自由变量,即使外部函数已经返回,闭包仍能记住并访问这些变量。
现在有个需求,需要每调用一次函数,返回的结果值就是增加一次之后的值。
1 | func autoIncrement() func() { |
在上述示例中,autoIncrement 函数返回了一个匿名函数,这个匿名函数构成了闭包。它能够访问并修改外部函数中的变量 local ,每次调用 autoIncrement 函数时,local 的值都会增加并返回。
为了更好的理解闭包概念,我们接下来由浅入深的剖析一下调用闭包时,栈帧上会发生些什么。
1.2 function value
在 go 语言中函数是头等对象,它可以作为参数传递,可以作为函数返回值,也可以绑定到变量。而 go 语言会称这样的参数、返回值或变量为 function value。
1 | func A() { |
函数的指令会在编译期间生成,而 function value 本质上是一个指针,但并不直接指向函数指令的入口。而是指向一个 runtime.funcval 结构体,这个结构体里只有一个地址,就是这个函数指令的入口地址。
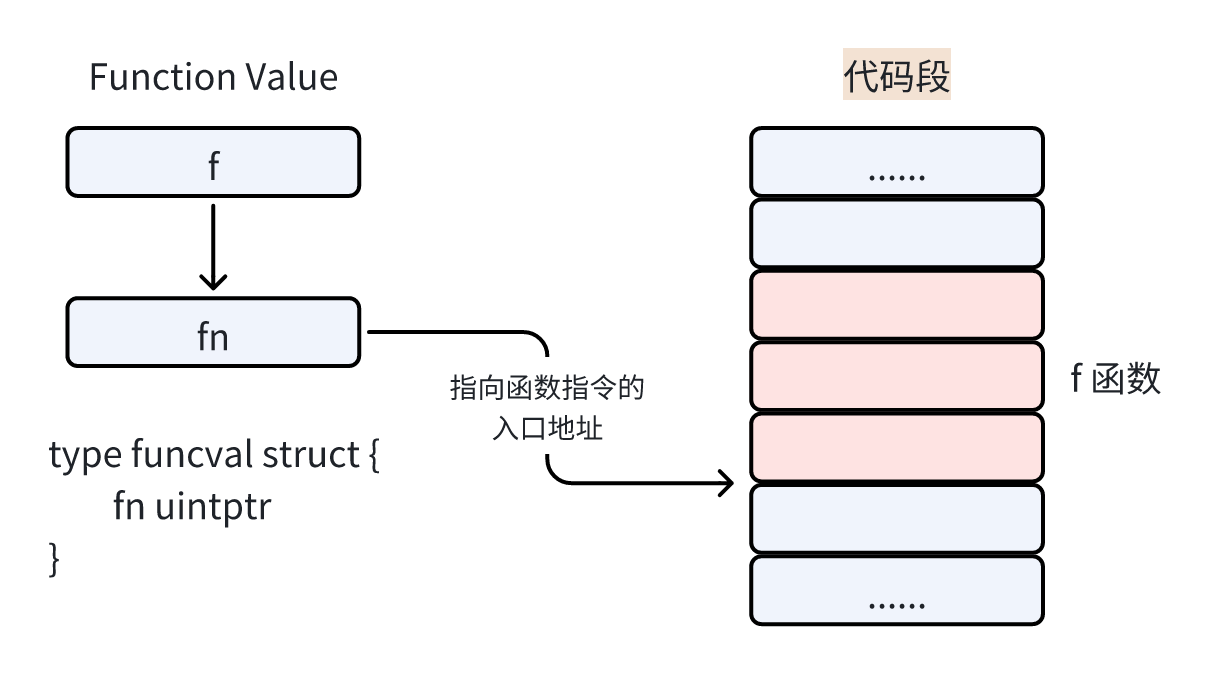
为了更深刻的理解这个内容,我们来举一个完整的例子,假设现在函数 A 被赋值给了 f1 和 f2 两个变量。
1 | func A(i int) { |
上面这种情况编译器就会做出优化,会让 f1 和 f2 共用一个 funcval 结构体,我们假设函数 A 的指令在下图代码段的这个位置,其入口地址为 addr1。
那么在编译阶段,就会在只读数据段分配一个 funcval 结构体,fn 指向函数 A 的指令入口。

而 fn 本身的起始地址 addr2 就会在执行阶段赋值给 f1 和 f2,如果通过 f1 来执行函数,则会通过它存储的地址找到对应的 funcval 结构体拿到函数的入口地址,然后再跳转执行。

再来看代码中 f1 函数的执行,我们传入的参数 i 为 1,执行到 A 函数中 i 会自增 1,那么下一步就会输出 2,而 f2 的调用完全相同。
那么问题来了,既然只要有函数入口地址就能调用,为什么还要通过 funcval 结构体包装这个地址,然后使用一个二级指针来调用呢?
这里主要是为了处理闭包的情况,我们再具体来看看维基百科是如何定义闭包的。这里有两个关键点需要我们注意:
- 必须要有在函数外部定义,但在函数内部引用的 “ 自由变量 “
- 即便脱离了闭包的上下文,闭包也能照常使用这些自由变量

1.3 不修改捕获变量
我们还是来看个例子,函数 create 的返回值是一个函数,但这个函数内部使用了外部定义的变量 c,即使 create 执行结束了,通过 f1 和 f2 依然能够正常调用这个闭包函数,并使用定义在 create 函数内部的局部变量 c。
所以下面代码中 return func() 这里符合闭包的定义,通常我们称这个变量 c 为捕获变量。
简单来说就是编译器在触发闭包条件时,会把这些东西扔到内存堆中,不会在函数结束后就释放它们,。
1 | func create() func(){ |
闭包函数的指令自然也在编译阶段生成,但因为每个闭包对象都要保存自己的捕获变量,所以要到执行阶段才会创建对应的闭包对象。
我们还是来看看栈帧分布情况,到 main 函数的执行阶段,存在两个局部变量,会分别初始化为空值。接着是返回值空间,目前同样初始化为空值。然后到了 create 函数栈帧这里,存在一个局部变量且初始化为 2。

create 函数还会在堆上分配一个 funcval 结构体,fn 指向闭包函数入口地址 addr1。除此之外,还有一个捕获列表,这里只捕获了一个变量 c。
然后这个结构体的起始地址 addr2,就被作为返回值写入返回值空间,因此执行完 f1 := create() 这行代码后,f1 就会被赋值为 addr2。

下面 f2 := create() 再次调用了 create 函数,它就会再次创建一个 funcval 结构体,同样会捕获变量 c。然后这个 funcval 结构体的起始地址 addr3 就会作为返回值写入到返回值空间,并最终赋值给 f2。

通过 f1 和 f2 调用闭包函数,就会找到各自对应的 funcval 结构体,从而就会拿到同一个函数的入口。但是 f1 和 f2 在调用闭包函数时,使用的捕获变量会不一样,会使用各自 funcval 结构体中的捕获变量,这就是称闭包为有状态的函数的原因。
那么问题又来了,闭包函数究竟如何找到对应的捕获列表呢?
在 go 语言中,通过一个 function value 调用函数时,会把对应的 funcval 结构体地址存入特定的寄存器。例如,amd64 平台使用的是 DX 寄存器。
这样在闭包函数中,就可以通过寄存器取出 funcval 结构体的地址,然后加上相应的偏移来找到每一个被捕获的变量。

因此在 go 语言中,闭包就是有捕获列表的 function value,而没有捕获列表的 function value 就直接忽略掉这个特定寄存器的值就好。
1.4 修改捕获变量
最后再来看看这个捕获列表,它可不是拷贝变量值这么简单,被闭包捕获的变量要在外层函数与闭包函数中表现一致,好像它们在使用同一个变量。为此,go 语言的编译器针对不同的情况做了不同的处理。
最简单的情况就像上面这个例子,被捕获的变量除了初始化赋值外,在任何地方都没有被修改过,所以直接拷贝到捕获列表中即可。
1 | func create() func(){ |
但是如果除了初始化赋值外,还被修改过的话,那就要再做细分。我们再来看一个例子,在下面这个例子中,被捕获的是局部变量 i,并且除了初始化赋值外还被修改过,来看看这种情况会怎么处理。
1 | fun create() (fs[2]func()) { |
假设闭包函数指令入口地址在代码段的 addrf 位置,main 函数栈帧中局部变量 fs 是一个长度为 2 的 functionvalue 类型数组,所以返回值也会分配 2 个位置,并且都会先初始化为空值。
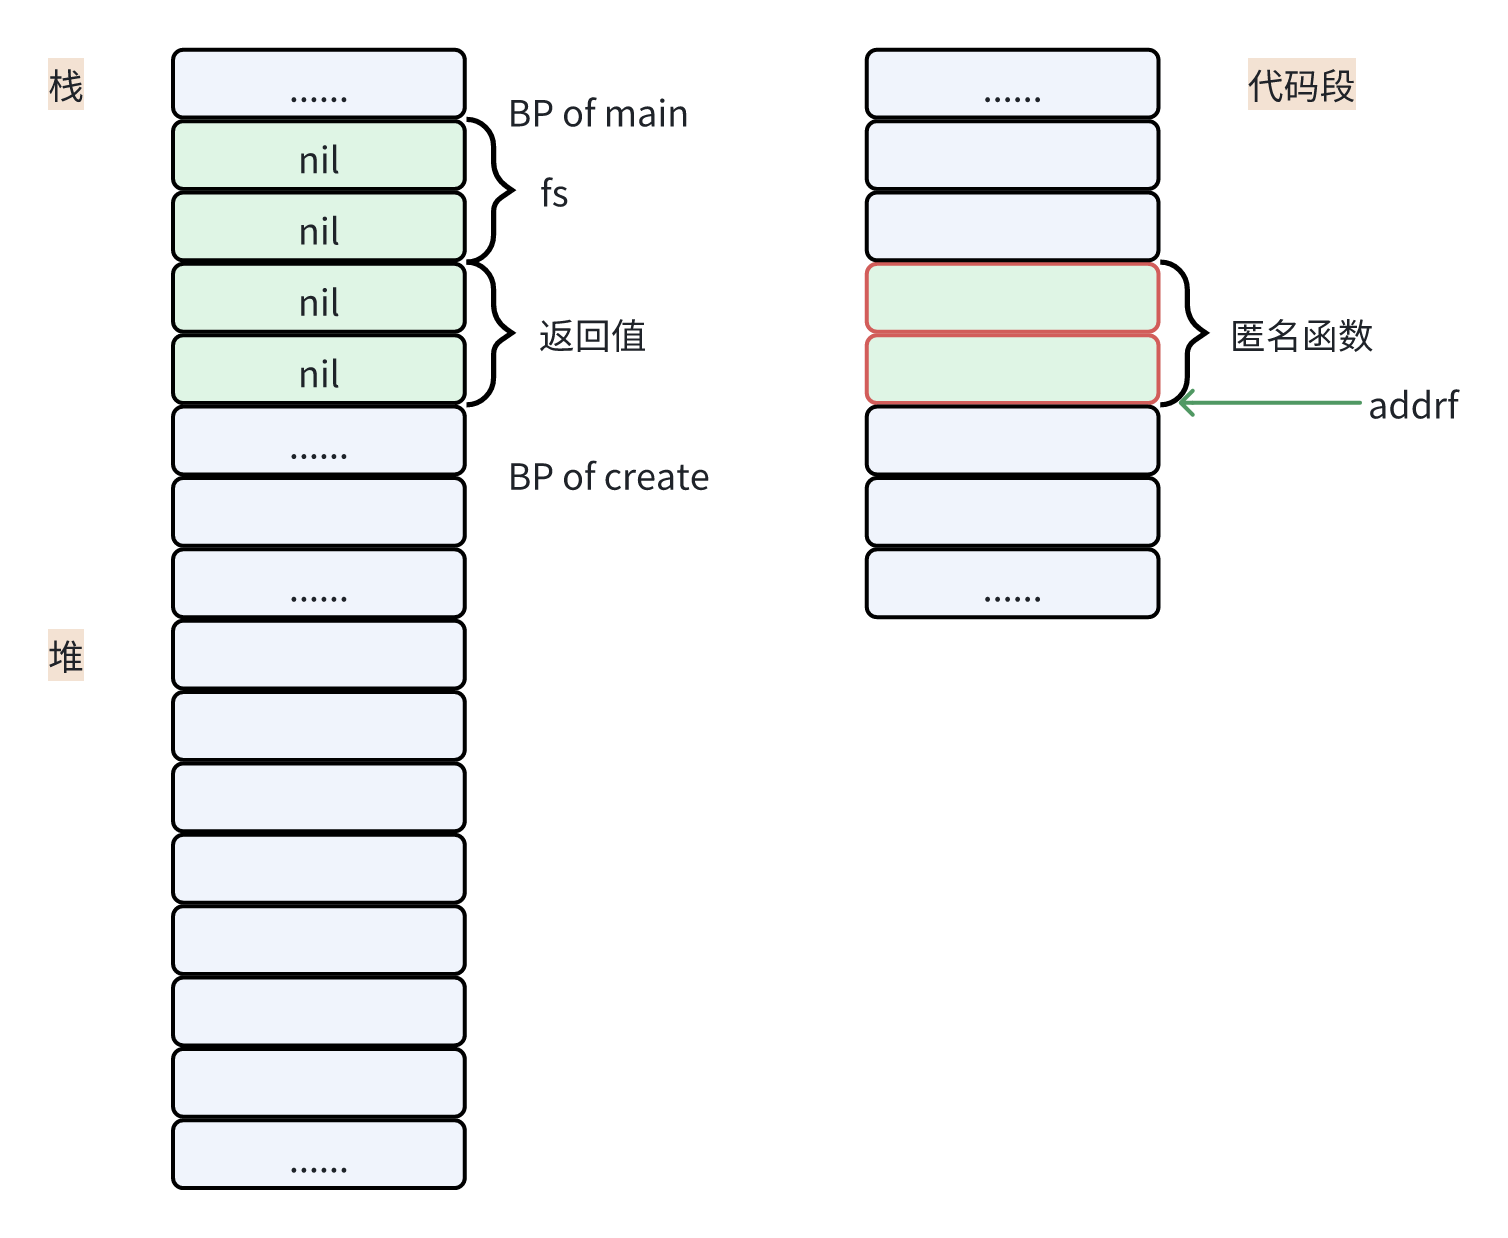
再来看看 create 函数栈帧,由于被闭包捕获,局部变量 i 会改为堆分配,在栈上只会存一个地址。执行到 create 第一次 for 循环,就会在堆上创建 funcval 结构体,并捕获 i 的地址,这样闭包函数就和外层函数操作同一个变量了。

因此返回值就会得到该 funcval 结构体的起始地址 addr0,然后 i 自增 1,此时第一次 for 循环结束。

接下来第二次 for 循环开始,和上面的步骤一样,这里会再次到堆上面创建一个 funcval 结构体,并捕获变量 i 的地址,因此第二个返回值的位置就会存储该 funcval 的起始地址 addr1。然后第二次循环结束,i 再次自增 1。

此时就满足了循环退出的条件,create 函数执行结束,于是就会将返回值拷贝到局部变量 fs 中。
当 fs[0] 调用函数时,就会把 addr0 存入到特定的寄存器中,然后闭包函数会通过寄存器存储的地址并加上偏移找到捕获变量 i 的地址。
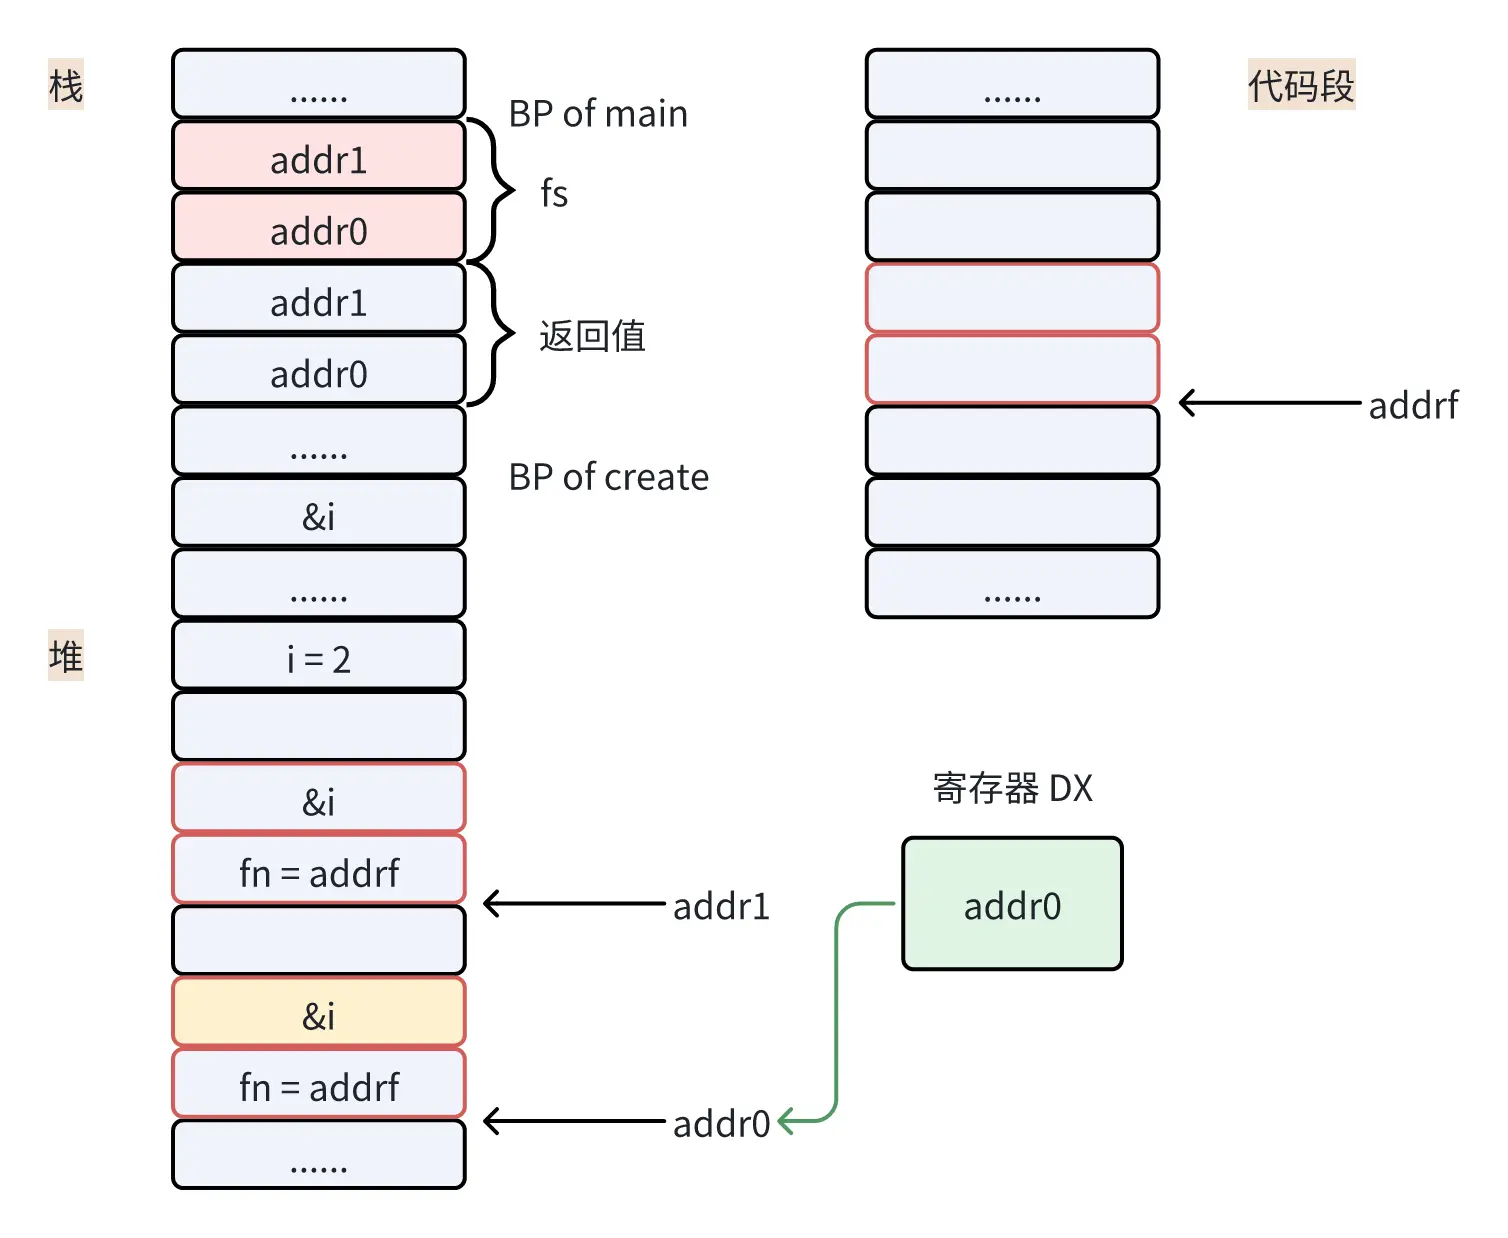
当 fs[1] 调用函数时同理,会把 addr1 存入到特定的寄存器中,闭包函数就会通过寄存器中的地址并加上偏移从而找到对应 funcval 中的捕获变量 i 的地址。

从上面两步可以看出,fs 每次调用函数,闭包函数最终得到的 i 的地址都是相同的,因此每次打印时输出都为 2。
闭包导致的局部变量堆分配,也是变量逃逸的一种场景。但如果修改并且被捕获的是参数,涉及到函数原型,就不能像局部变量那样处理了。
不过参数依然是通过调用者栈帧传入,但是编译器会把栈上的这个参数拷贝到堆上一份,然后外层函数和闭包函数都使用堆上分配的这一个。

如果被捕获的是返回值,处理方式就又有些不同,调用者栈帧上依然会分配返回值空间,不过闭包的外层函数也会在堆上分配一个,外层函数和闭包函数都使用堆上这一个,但是在外层函数返回前,需要把堆上的返回值拷贝到栈上的对应返回值空间。

处理方式虽然多样,但是目标只有一个,就是保持捕获变量在外层函数与闭包函数中的一致性。并且细致分析的话也可以发现,这几种处理方式起始也都比较类似,就是在堆上保存被捕获的值,防止在函数结束时被释放了。
本小节关键点:
- go 语言中的 function value 本质上是指向 funcval 结构体的指针
- go 语言中的闭包只是拥有捕获列表的 function value
- 捕获变量在外层函数与闭包函数中要保持一致
2. Defer 详解
2.1 快速了解
defer 后面的代码会在函数 return 后执行,并且执行的顺序是与代码的顺序相反,即倒序执行。
1 | //main 2 1 |
使用 defer 需要注意其执行的时机,以免造成意料之外的影响,例如它可能会修改返回值:
1 | func deferReturn() (ret int) { |
2.2 defer 执行逻辑
我们先来看一段简洁的代码。
1 | func A() { |
上面这段代码,编译后的伪指令是下面这样的。defer 指令对应到两部分内容,其中 deferproc 负责把要执行的函数信息保存起来,我们称之为 defer 注册。而 deferproc 函数会返回 0,下面 if 分支和 panic recover 有关,可以先忽略不看,同时对应要跳转的 ret 这里也先忽略不看。
1 | func A() { |
去掉忽略的部分,程序的整体逻辑就比较清晰了。在 defer 注册完成后,程序就会执行后面的逻辑,直到返回之前通过 deferreturn 执行注册的 defer 函数,即 defer 调用。正是因为先注册后调用,才实现了 defer 延迟执行的效果。
1 | func A() { |
看回 defer 注册部分,defer 注册的信息会注册到一个链表,而当前执行的 goroutine 会持有这个链表的头指针。每个 goroutine 在运行时都有一个对应的结构体 g,其中有一个字段就指向 defer 链表头。
defer 链表链起来的是一个一个 _defer 结构体,新注册的 defer 会添加到链表头,执行时也是从头开始,这也就是 defer 会表现为倒序执行的原因。

在展开 _defer 结构之前,先看一个例子,这里函数 A 注册了一个 defer 函数 A1。
1 | func A1(a int) { |
我们来看看函数调用栈,A 的栈帧首先会是存放两个局部变量。接着 A1 只有一个参数,因此局部变量下面存放参数 a 的值 1,然后就要注册 defer 函数 A1 了。

deferproc 函数原型只有两个参数,第一个参数是 defer 函数 A1 的参数加返回值共占多大空间。这里 A1 没有返回值,只需要一个整形参数和一个指针变量,因此 64 位下要占 4 字节。
1 | func deferproc (siz int32, fn *funcval) |
第二个参数是一个 function value,前面函数部分我们也介绍过,没有捕获列表的 function value 在编译阶段就会做出优化,即在只读数据段分配一个共用的 funcval 结构体,结构体中的指针会指向函数 A1 指令入口,所以 deferproc 的第二个参数就是结构体的地址 addr2。
1 | func deferproc (siz = 4, fn = addr2) |

至此我们先把 _defer 的结构体展开了看一下:
1 | type _defer struct { |
当 deferproc 函数调用时,编译器会在后面继续开辟一段空间,用于存放 defer 函数的返回值和参数,由于在这个例子里没有返回值,因此只分配 defer 函数的一个参数的空间,这一段空间会被直接拷贝到 _defer 结构体的后面。
另外,返回值地址和调用者函数的 BP 则放在 deferproc 两个参数之后。

在 deferproc 函数执行时,需要堆分配一段空间用于存放 _defer 结构体,而在 _defer 结构体后面也会分配一段空间用于存放 siz 大小的参数与返回值,这里由于没有返回值因此存放参数 a。(注意这里所有的变量存放的顺序是从下至上的,因此参数 a 虽然说是存放在 _defer 结构体的后面,但其实分配的空间在该结构体存放的位置之上)

然后这个 _defer 结构体就会被添加到 defer 链表头,至此 deferproc 注册结束。
_defer 结构体预分配
实际上 go 语言会预分配不同规格的 defer 池,执行时从空闲的 _defer 中取一个出来用即可。如果没有空闲的或者没有大小合适的,则会再进行堆分配,用完以后再放回空闲的 _defer 池,这样就可以避免频繁地堆分配与回收。
让我们再回到函数代码的执行,当代码执行到函数 A 中的 a = a + b 这行代码时,变量 a 被赋值为 3,然后下一步会输出局部变量 a 和 b 的值,即 3 和 2。

接下来就到 deferreturn 执行 defer 链表了,此时会从当前 goroutine 拿到链表头上的这个 _defer 结构体,通过 _defer 结构体里的 fn = addr2 找到对应的 funcval,然后通过 funcval 中的 fn 可以拿到函数入口的地址 addr1。
在调用 A1 时,会把 _defer 后面的参数与返回值整个拷贝到 A1 的调用者栈上,然后 A1 开始执行,此时就会输出 1。
这里的关键是 defer 函数的参数在注册时拷贝到堆上,执行时又拷贝到栈上。并不会去使用到 A 函数栈中保存的局部变量 a 的值 3,所以即使在 defer 函数注册后修改了这个局部变量 a 的值,也不会影响到执行 defer 函数时用到的变量 a。

既然 deferproc 注册的是一个 function value,我们下面就来看看捕获列表时是什么情况,变量 a 在 defer 函数注册后进行修改是否能影响到 defer 函数里使用的变量。
2.3 defer + 闭包
在下面这个例子中,defer 函数不止要传递局部变量 b 做参数,还捕获了外层函数的局部变量 a 并形成了闭包。
1 | func A() { |
匿名函数会由编译器按照 A_func1 这样的形式命名。如下图所示,假设这个闭包函数的指令入口地址为 addr1。
由于捕获变量 a 除了初始化赋值外还被修改过,所以局部变量 a 改为堆分配,而栈上存储它的地址。另外,还有一个局部变量 b 也要分配。

然后创建闭包对象,堆分配一个 funcval 结构体,并且捕获列表中存储 a 的地址。
deferproc 执行时,_defer 结构体中的 fn 就是这个 funcval 结构体的起始地址。除此之外,还要拷贝参数 b 的值到 _defer 结构体的后面,然后把这个 _defer 结构体添加到 defer 链表头。
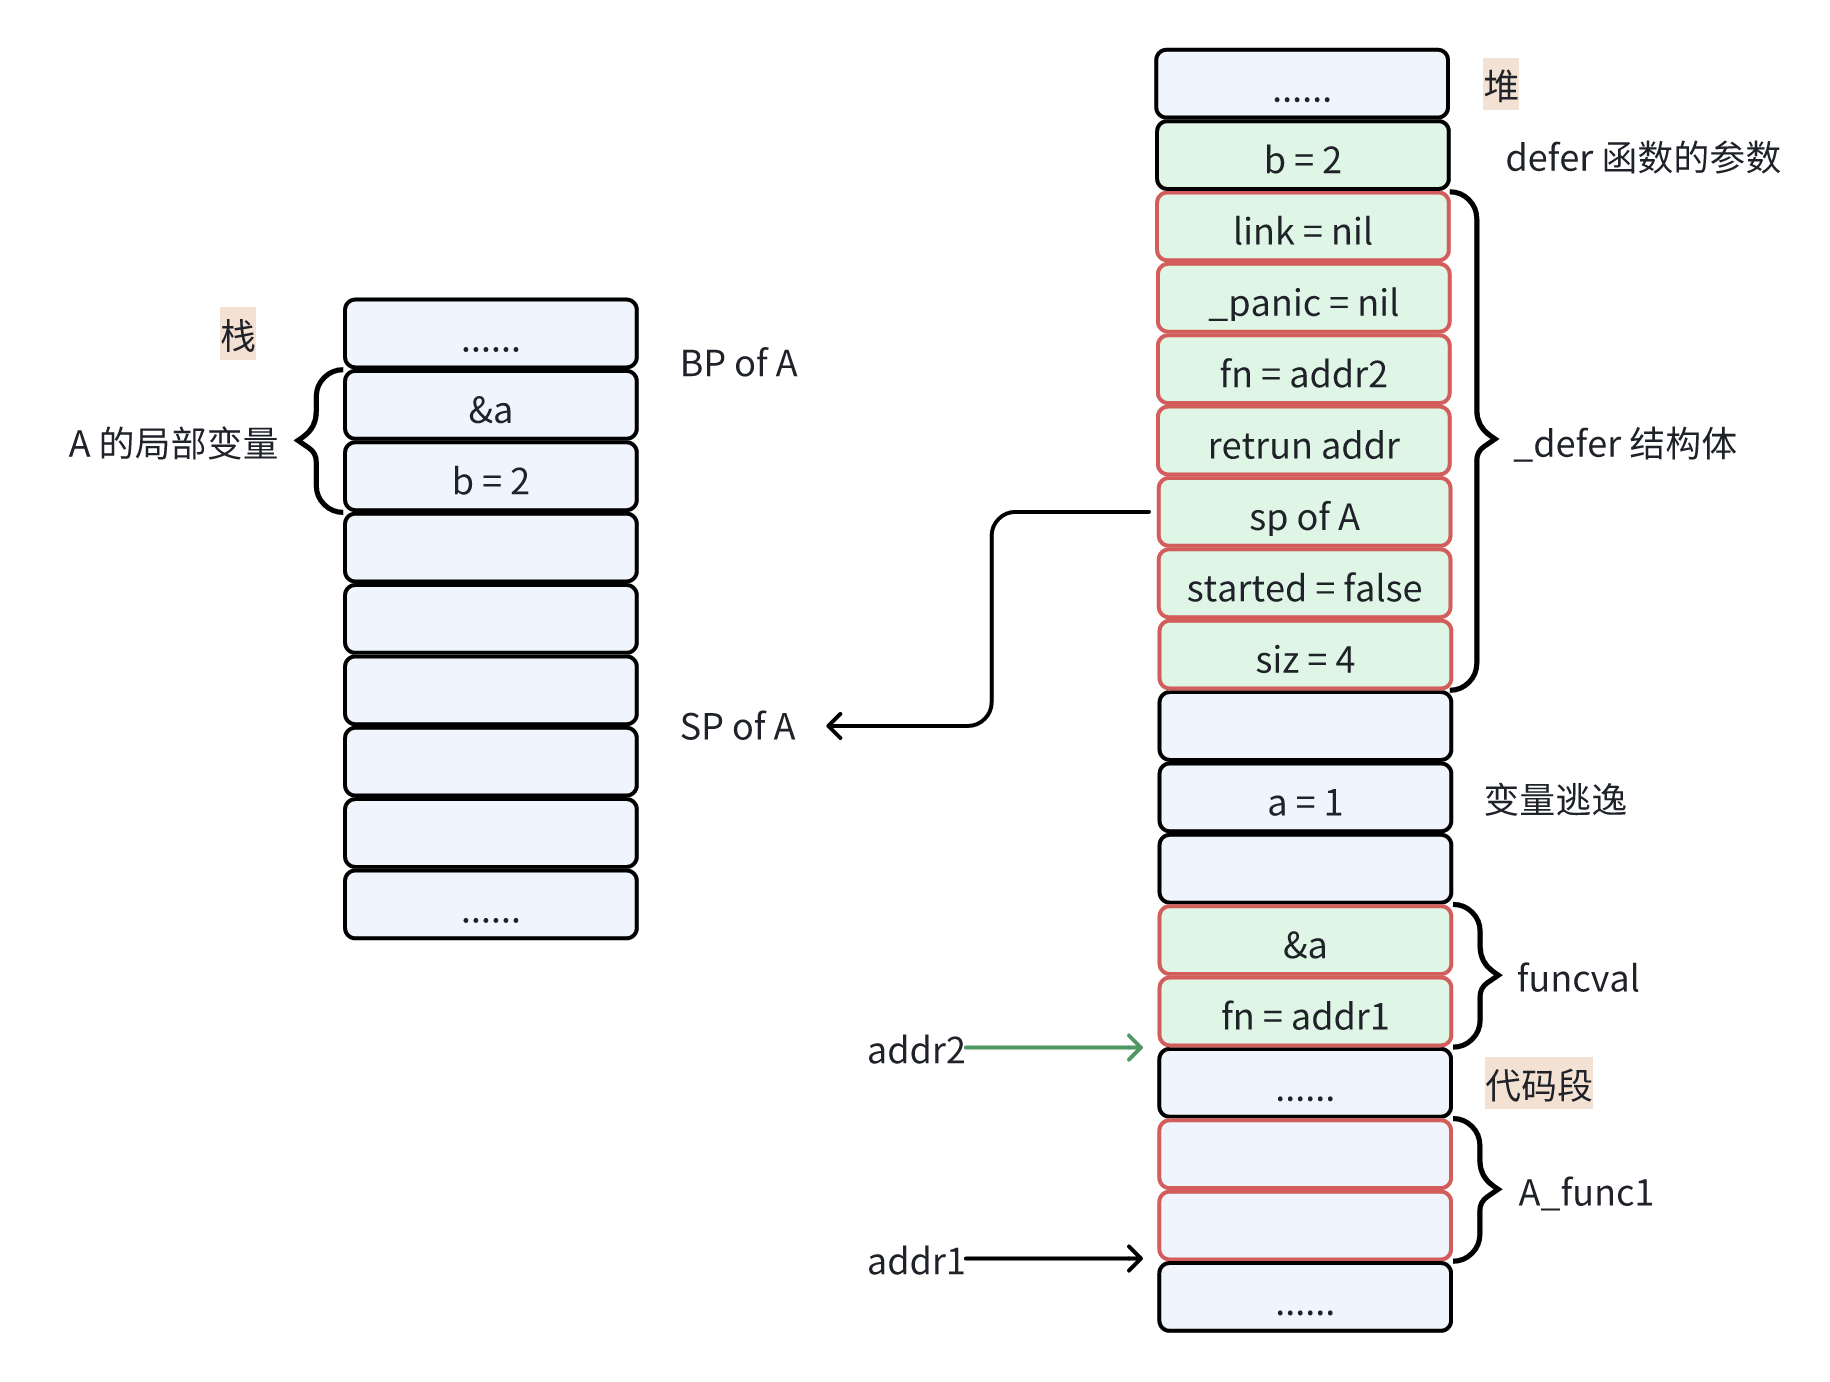
至此,deferproc 注册结束。然后接着执行到 a = a + b 这行代码,变量 a 被赋值为 3。而下一步就自然输出 a 和 b 的变量值,即 3 和 2。

接着就到 deferreturn 了,从 defer 链表头拿到这个 defer 结构体,执行注册的 defer 函数时,需要把参数 b 拷贝到栈上的参数空间。
另外,闭包函数也会通过寄存器存储的 funcval 地址加上偏移,找到捕获变量 a 的地址。

当执行到 defer 函数 A_func1 里的 a = a + b 这行代码时,此时的 a = 3 且 b = 2,所以 a 会被赋值为 5。因此,下一步将会输出变量 a 和 b 的值,即 5 和 2。
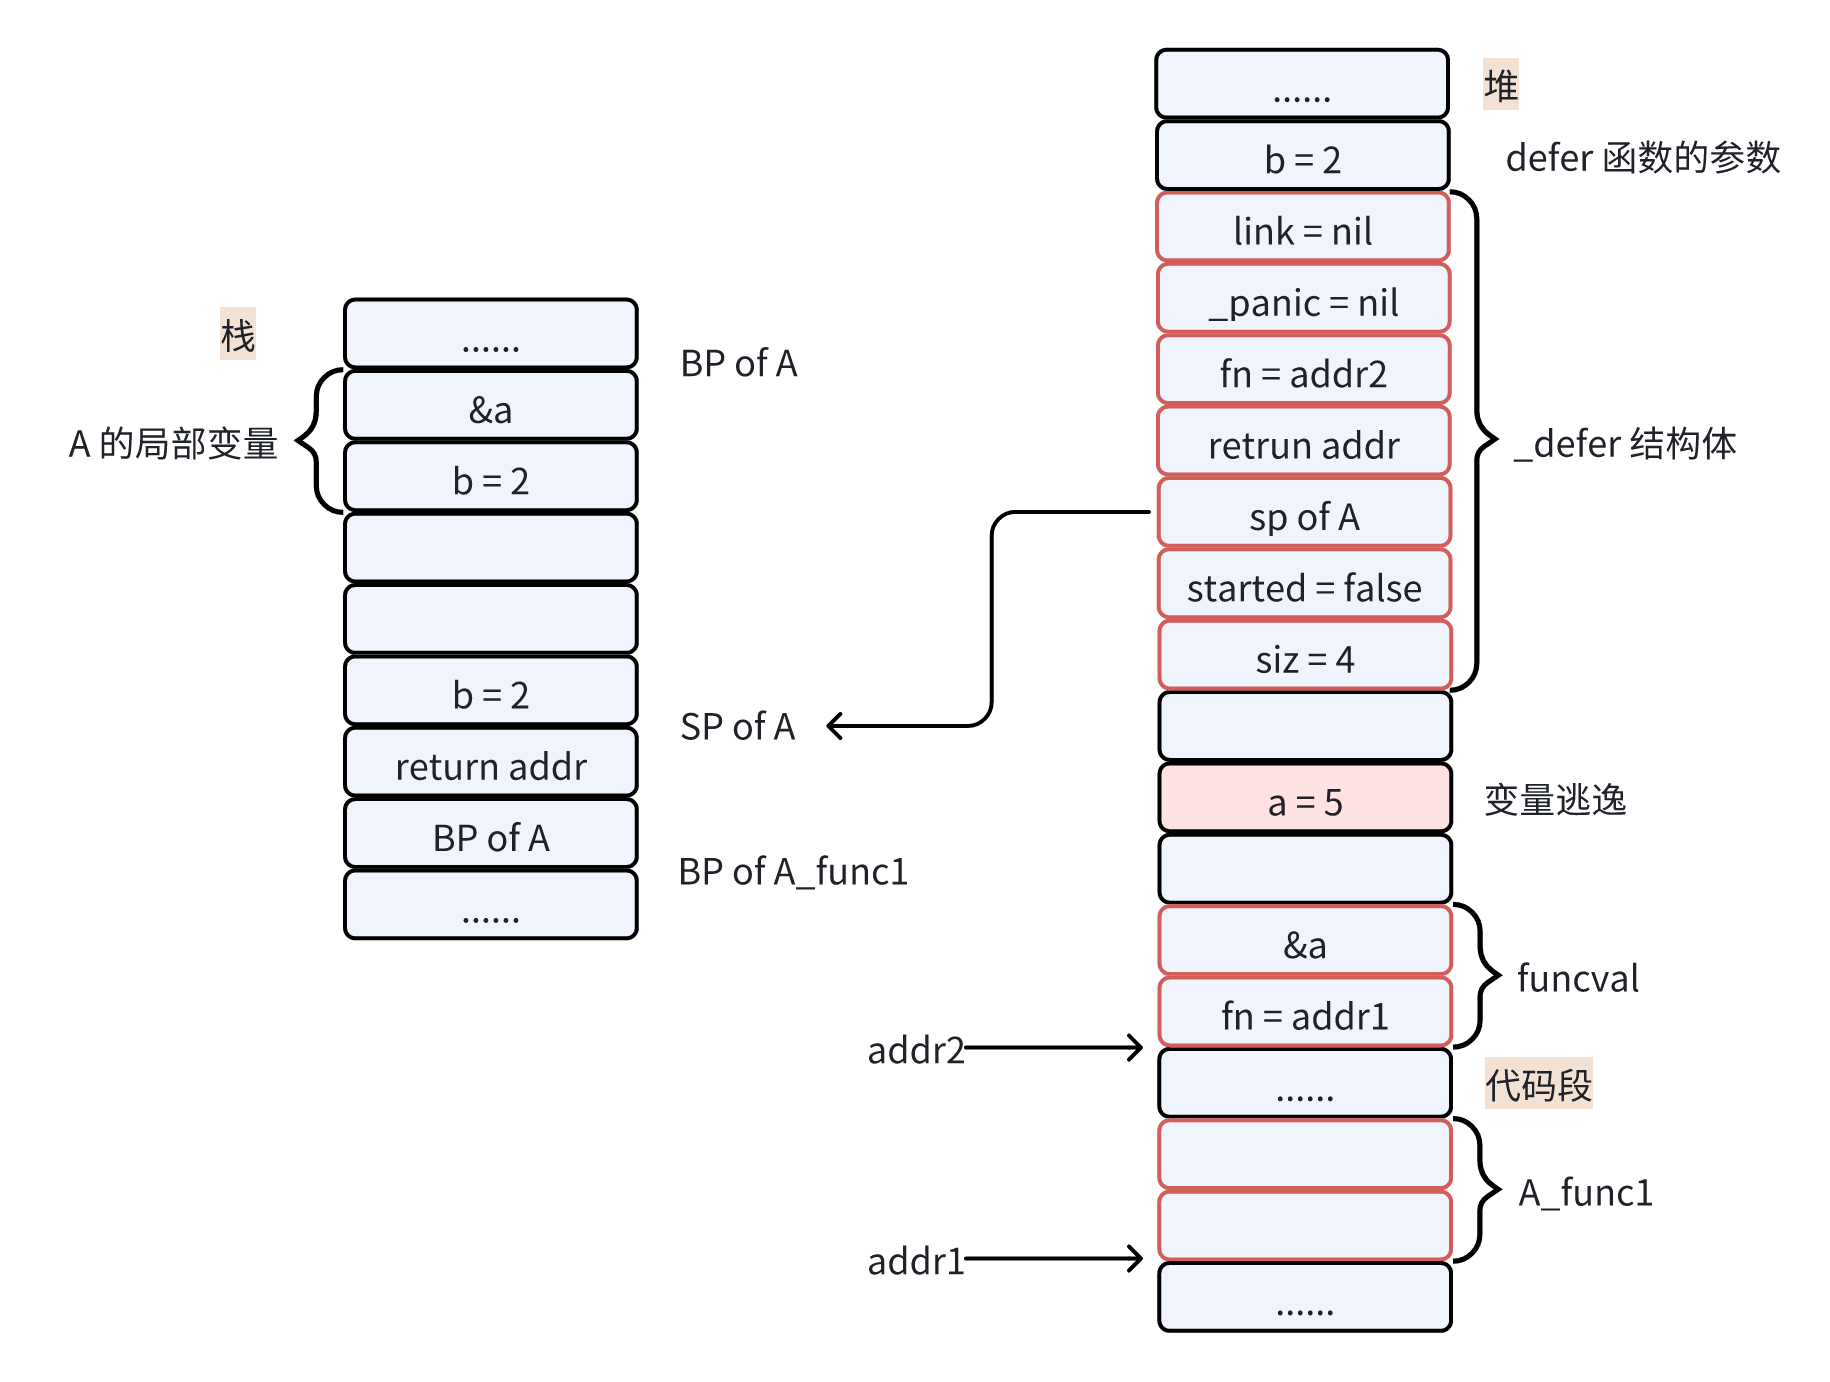
可以发现当变量 a 变成被捕获的变量形成闭包后,在注册完 defer 函数后修改变量 a 是可以影响到 defer 函数中使用的变量值的。这是因为此时的变量 a 发生了逃逸,不再分配到栈上而是分配到堆上,defer 函数的变量 a 最终将会从堆上获取具体的值。
2.4 函数嵌套
我们再来看一个形如 defer(A(B(c)) 这样的例子,看看 defer 执行时参数 a 到底等于多少。
1 | func B(a int) int { |
这个例子中,main 函数注册的 defer 函数是 A,所以 defer 链表中 _defer.fn 存储的是 A 的 funcval 指针。但是在 deferproc 执行时,需要保存 A 的参数到 _defer 结构体的后面,因此需要在这时候就拿到 defer 函数注册时 A 传入的参数,即需要此刻计算出 B(1) 的返回值作为参数传入。

所以 A 最终会得到 B(1) = 2 的参数进行传入,又因为该参数不存在捕获的条件即不会形成闭包,也就等于传入的这个参数固定下来了,后面再去修改参数 a 也不会影响到 defer 函数最终的结果。因此,最终 defer A(B(a)) 将会输出 3。
2.5 defer 嵌套
最后再来看一个 defer 嵌套的例子,这次抛开所有细节只看 defer 链表随着 A 的执行会怎样变化。
1 | func A() { |
首先函数 A 注册了两个 defer,这里途中我们用 A1 和 A2 函数名进行标记。

在函数 A 返回前执行 deferreturn 时,会判断 defer 链表头上的 defer 是不是 A 注册的。而这个方法就是判断 defer 结构体记录的 sp 是否等于 A 的栈指针,即判断 A2.sp == SP of A 是否成立。
如果是 A 注册的,就会保存函数的相关信息,就会把它从 defer 链表中移除并执行函数 A2,此时又会注册两个 defer,并记为 B1 和 B2。

在 A2 返回前同样会去执行 defer 链表,同样判断是否是自己注册的 defer 函数,即判断 B2.sp == SP of A2 是否成立。然后 B2 执行,同样的流程 B1 执行。此时 A2 仍不知道自己注册的 defer 已经执行完了,直到下一个 _defer.sp 不等于自己的栈指针,然后 A2 就可以结束了。

再次回到 A 的 defer 执行流程,然后执行 A1,当 A1 执行结束后 defer 链表为空,函数 A 结束。这个例子的关键是 defer 链表注册时添加链表项,执行时移除链表项的用法。
至此 go 1.12 版本的 defer 基本设计思路就梳理完了,这个版本的 defer 一个明显的问题就是慢。
- 其中一个原因是 _defer 结构体堆分配,即使有预分配的 deferpool,也需要去堆上获取与释放,而且参数还要在堆栈之间来回拷贝。
- 第二个原因是使用链表注册 defer 信息,而链表本身操作就比较慢。
所以 go 在 1.13 和 1.14 中分别作了不同的优化。